小叶想整理一份校园活动名单,供同学挑选还有名额的活动。活动资料保存在一个查询服务里,他自己的程序负责取回资料、筛选,再把名单存成文件。这件事看起来只是“把那边的数据拿过来”,实际却有好几处需要作判断:向哪个入口询问,怎样表达查询条件,收到的东西能不能直接使用,什么时候才算拿全,以及程序没有等到答复时该怎么办。
如果把这些问题全部交给AI,它也许很快就能写出一段会显示结果的代码。但显示出两个活动,可能只说明取回了第一页;打印出“成功”,可能只说明服务接收了请求。我们需要看懂数据从哪里来,经过了哪些处理,最后的结果支持什么判断。这是本章学习API的出发点。
本章使用一个能在自己电脑上运行的教学服务。所有活动、名额和业务情景均为虚构,不连接学校系统,也不产生真实报名。我们先把一次完整查询做明白,再考察“查询资料”和“让服务执行动作”有什么区别。
一、API让一个程序能够使用另一个部分的能力
API的中文通常译为“应用程序编程接口”。这里的接口,可以理解为供程序使用某项功能的一组约定:调用什么入口,交给它什么,能得到什么,以及哪些事情需要由调用者负责。
前面学过的函数就能帮助我们理解。假如一个函数接收活动记录,返回剩余名额,小叶只要知道参数和返回值的约定,就能调用它,不必每次都研究函数内部怎样计算。库也会提供一组这样的入口。接口把“怎样使用功能”和“功能内部怎样实现”分开,使不同部分能够合作。
现在,活动资料由另一个正在运行的程序管理。小叶不能直接访问它的Python变量。提供方可以开出一个查询入口,让小叶的程序提交查询条件,再把符合条件的资料发回来。这也是API的一种使用方式。本章主要讨论通过HTTP通信的API,HTTP是客户端和服务器交换请求、响应时使用的一套协议。
客户端是这次主动提出请求的一方,服务器是接收并处理请求、提供答复的一方。在本章里,小叶运行的查询脚本是客户端,活动服务是服务器。两者可以在不同电脑上,也可以像我们的实验一样,在同一台电脑的不同进程里运行。角色由当前协作关系决定,并不取决于电脑大小。你用浏览器打开网页时,浏览器通常也在充当客户端。
这个区别能帮助小叶检查AI生成的程序。当程序没有拿到预期的活动资料时,可以先看客户端是否发出了正确的查询,再看服务如何答复。请求还没发出,就需要先检查本地执行;服务已经返回空结果,则要结合查询条件与服务资料判断。分清由谁管理资料、由谁提出查询,才能找到相应的检查方向。
接口也不等于一个网址。一个网址能帮助程序找到入口,但它没有自动告诉我们该用什么方法、哪些参数有效、结果有哪些字段。把网址粘贴给AI,再说“帮我接通”,还缺少不少必要信息。真正能够被使用的接口,包含入口背后的约定。
二、先看清约定,才知道怎样才算完成
我们的教学服务提供三条固定活动记录:
| 活动编号 | 活动名称 | 剩余名额 |
|---|---|---|
| 001 | 写作交流 | 8 |
| 002 | 数据练习 | 0 |
| 003 | 阅读讨论 | 5 |
编号是文本,前面的零属于编号。剩余名额是非负整数,零表示当前没有剩余名额。服务把这组固定资料标记为demo-v1,称为一个快照。本章中,这个快照的三条记录在查询期间保持不变。
小叶的完成标准是:取回这个快照里的全部活动,筛选出剩余名额大于零的项目,保存名单,并能够解释名单是否遗漏。他要做的是提供挑选活动的参考,没有执行报名。即使真实服务刚刚显示还有名额,查询结果也不能替代后续报名确认;在我们的固定教学数据中,可以先集中理解取得资料的过程。
服务对查询入口作了以下约定。它们是本章教学服务的规则,并不是所有API都必须采用的格式。
| 项目 | 本服务的约定 |
|---|---|
| 入口 | GET /activities |
可选参数q |
活动名称包含这段文本;省略或空文本表示不按名称筛选 |
可选参数cursor |
从上一页响应取得的后续位置;首次请求省略 |
| 每页容量 | 最多返回两条活动 |
| 成功响应 | 状态码200,JSON格式,UTF-8编码 |
items |
当前页的活动列表,每条含activity_id、title、remaining |
next_cursor |
非空文本表示还有下一页;null表示已经到末页 |
total |
当前查询条件下,整个快照中符合条件的活动总数 |
snapshot |
当前固定资料的标记,本例为demo-v1 |
这个表最关键的地方,是把“这一页”和“整个查询结果”分开了。小叶在第一页看到两条记录,同时看到总数为三,不能把两条记录解释成服务里只有两项活动。数据没有丢在网络中,而是服务本来就约定分批返回。
同样,字段名不能凭日常语言猜。remaining在这里表示剩余名额,如果另一家服务把相似字段用于剩余活动时长,再把它当成名额数量来筛选,就可能选错活动。接口文档告诉我们字段的含义、类型和范围,代码只是把已经明确的约定执行出来。
三、用URL找到入口,用参数表达条件
先看一个本机查询地址:
http://127.0.0.1:8766/activities?q=reading
http说明使用的通信协议;127.0.0.1指向当前电脑自己;8766是端口号,用于找到这台电脑上相应的服务入口;/activities是服务识别的路径;问号后面的q=reading是查询参数。这里的reading只是展示URL结构的参数值,我们的中文活动名称并不包含它,因此按本服务的规则查询会得到零条活动。
路径看起来很像文件路径,但服务器可以把/activities交给查询程序处理,不必在磁盘上真的有一个叫activities的文件。小叶使用的是服务公开的入口,不是借这个路径直接翻阅对方文件夹。
查询参数把具体要求带给服务。假如要找“阅读讨论”,小叶应当传递这个完整名称。名称中还可能出现空格、汉字或&等字符,而&在查询字符串里又有分隔参数的作用。直接把任意文本拼到网址后面,可能改变原来的结构。因此,我们把原始条件交给专门的函数编码。
下面的代码可保存为query_url.py。它只构造地址,不发出网络请求。
from urllib.parse import urlencode

base = "http://127.0.0.1:8766"
params = {"q": "阅读讨论"}
url = base + "/activities?" + urlencode(params)
print(url)
输出里会出现一段百分号和字母数字组成的文本。这是把查询内容表达成URL能够传递的形式,服务解析后仍应得到“阅读讨论”。你不必记住每个汉字对应的编码;应当知道在什么地方交给urlencode处理,而不要擅自改写用户输入。Python文档说明了查询参数的编码与解析约定。
编码也不是加密。把内容转换成另一种表示,并没有赋予它保密性。真实服务通常使用HTTPS保护传输;本章只与自己电脑上的教学服务通信,使用HTTP便于观察基本过程。涉及账号凭据时,我们还需要按服务规定提供身份信息,这留到后面的动作请求一起说明。
四、实际发出一次请求
先把配套教学服务文件保存到准备做实验的文件夹。电脑需要有Python 3;下面的代码使用Python标准库,不必另装网络请求包。
在这个文件夹打开终端,运行:
python activity_server.py --port 8766
终端出现“教学服务已启动”并显示本机地址后,先让它继续运行。这个窗口在等待请求,没有返回命令提示符是正常现象。另开一个终端,在同一文件夹运行下面的客户端文件。全部实验结束后,回到服务窗口按Ctrl+C停止。教学服务仅监听本机,重启后草稿记录清空。
如果提示端口被占用,可以将启动参数改为另一个空闲端口,例如--port 8767,并同步修改客户端里的地址。本章后续都按8766说明。服务尚未启动时,单独运行客户端不能得到这里的结果;两个程序共同运行,是实验的必要条件。
把以下内容保存为first_request.py,再运行python first_request.py:
from urllib.request import Request, build_opener, ProxyHandler

base = "http://127.0.0.1:8766"
opener = build_opener(ProxyHandler({}))
request = Request(base + "/activities", method="GET")

with opener.open(request, timeout=3) as response:
    status = response.status
    content_type = response.headers.get_content_type()
    raw = response.read()

print(status)
print(content_type)
print(type(raw).__name__)
print(raw.decode("utf-8"))
这里,Request把请求地址和方法组织成一个请求对象;opener.open实际发出请求并等待响应。ProxyHandler({})让这组本机实验直接连接教学服务,避免电脑已有代理设置改变本机请求的去向。换成真实服务时,网络连接方式应按实际环境设置,不必把这一项当成所有API代码的固定写法。
with管理响应对象的使用,退出时关闭它。我们在里面先取出后续需要的状态、类型和响应内容。response.read()得到的是字节,因此第三行输出是bytes。最后一行把字节按UTF-8解码,才成为可以阅读的文本。timeout=3为等待连接建立或数据到达这类操作设置超时参数;程序可能经历多次等待,因此它不是整项多次请求任务必定在三秒内结束的承诺。这些调用行为见Python的请求模块文档。
前两行输出应为200和application/json,最后显示第一页的JSON文本。现在可以先观察:文字中确实有活动,但它同时带着next_cursor、total和snapshot。服务交给我们的不只是一份活动清单,也包括理解这份清单范围所需的信息。
如果这一步没有运行成功,先确认服务终端还在运行,地址和端口是否一致。我们稍后会区分服务返回错误与没有取得响应的情况;此时没有必要一开始就给代码加上自动循环重试。先让一条请求及其答复清楚可见,更容易知道程序实际做到了哪一步。
五、响应里的三种信息,分别回答三个问题
HTTP响应包含状态信息、响应头和响应体。它们一起构成一次答复,却承担不同作用。可以把刚才那次响应概括为下表:
| 看到的部分 | 本次内容 | 能帮助判断什么 |
|---|---|---|
| 状态码 | 200 | 服务报告这次请求成功 |
| 响应头中的内容类型 | application/json; charset=utf-8 |
服务声明响应体采用JSON,并在本例中标明UTF-8编码 |
| 响应体 | 包含活动和分页信息的JSON文本 | 活动是什么,还有没有后续结果 |
状态码先帮助小叶判断应当怎样理解这次答复。200表示请求成功,但成功的含义与请求方法、接口约定有关。一次查询成功,可以返回空列表;“没有符合条件的活动”本身也可能是一份正常结果。如果小叶根据已有资料预期会有匹配记录,却拿到空列表,就需要进一步检查条件是否传错或数据是否变化。
另一些状态码会把处理方向引到别处。例如,本服务收到不存在的路径会返回404;收到它不接受的查询参数会返回400。我们不必在这里背一张完整状态码表,而应当把它们用于当前判断:路径写错时,继续调整筛选表达式解决不了入口问题;查询条件不合要求时,重新安装Python也没有改变服务收到的条件。
响应头的内容类型则告诉客户端按什么格式理解响应体。名字里有“头”,并不表示它是正文的第一句话;程序通过response.headers取到这部分信息。响应体才是response.read()读取的内容。它可以是JSON,也可以是图片、文本或其他数据,本章的活动接口只是选择了JSON。
这里还要分清“声明”与“实际内容”。一个服务即使把内容类型写成JSON,响应体也可能因程序错误而缺少右括号。状态码200和内容类型正确,不能替我们完成后面的解析。这不是要怀疑每一次正常响应,而是要让程序用接下来的步骤把判断落实:能否解码,能否解析,解析出来是否符合约定。
这样的分层会让错误更容易处理。小叶如果在任何地方遇到问题都打印“没有活动”,那么连接失败、格式损坏和正常空结果就混在一起了。同学看到空名单,还可能误以为所有活动都已满员。保留不同阶段的含义,才能把“没有得到可用答案”与“答案是没有符合条件的活动”区分开。
六、从收到字节,到能够处理一条活动
第一份客户端代码已经得到raw。在同一个文件末尾继续加入下面几行,就能把响应内容变成Python对象:
import json

text = raw.decode("utf-8")
page = json.loads(text)
print(type(page).__name__)
print(page["items"][0]["title"])
新增的两行输出是dict和写作交流,前一个代码块的输出仍会保留。这里发生了两次不同的转换。解码把字节变成文本,JSON解析再把文本里的结构变成字典、列表、数字等Python对象。直接对raw使用活动字段名取值不会完成这两步;对一段JSON文本寻找某个汉字,也不等于已经取得对应字段。
拿到字典以后,第一条活动位于page["items"][0],它的名称位于这条记录的"title"字段。访问顺序来自实际结构:先进入当前页的活动列表,再选一条记录,最后取字段。学会顺着结构找到对象,比记住某家API的一串固定索引更容易迁移。
但“解析成了字典”仍然只说明结构能够被读取。设想服务把remaining从整数8改成文本"8"。这仍是合法JSON,解析也会正常结束,可小叶原来按整数比较剩余名额的代码便不符合新数据的类型。又比如字段完全消失,程序更不能擅自把缺失解释成零名额。
因此,我们把本章需要的约定写进一个检查函数。下面代码保存为api_client.py。后面一节还会向这个文件追加分页函数;也可以直接使用完整配套客户端。检查失败时,raise ValueError(...)会抛出异常,停止当前正常流程,并说明哪个约定没有满足。这样错误资料就不会继续进入名单。
import json
from urllib.parse import urlencode
from urllib.request import Request, build_opener, ProxyHandler

BASE = "http://127.0.0.1:8766"
OPENER = build_opener(ProxyHandler({}))

def validate_page(page):
    if not isinstance(page, dict):
        raise ValueError("响应应当是对象")
    if not isinstance(page.get("items"), list):
        raise ValueError("items应当是列表")
    if type(page.get("total")) is not int or page["total"] < 0:
        raise ValueError("total应当是非负整数")
    if not isinstance(page.get("snapshot"), str) or not page["snapshot"]:
        raise ValueError("缺少有效快照标记")
    if "next_cursor" not in page:
        raise ValueError("缺少后续位置字段")
    cursor = page["next_cursor"]
    if cursor is not None and (not isinstance(cursor, str) or not cursor):
        raise ValueError("后续位置应当是非空文本或null")
    for item in page["items"]:
        if not isinstance(item, dict):
            raise ValueError("活动记录应当是对象")
        for key in ("activity_id", "title"):
            if not isinstance(item.get(key), str) or not item[key]:
                raise ValueError("活动编号和名称应当是非空文本")
        if type(item.get("remaining")) is not int or item["remaining"] < 0:
            raise ValueError("剩余名额应当是非负整数")

def get_page(params):
    url = BASE + "/activities?" + urlencode(params)
    request = Request(url, method="GET")
    with OPENER.open(request, timeout=3) as response:
        if response.status != 200:
            raise ValueError("活动查询未返回约定的200状态")
        if response.headers.get_content_type() != "application/json":
            raise ValueError("活动查询未返回约定的JSON类型")
        raw = response.read()
    page = json.loads(raw.decode("utf-8"))
    validate_page(page)
    return page
这一段较长,可以先顺着get_page看完整动作,再回头看validate_page逐项检查了什么。前者负责组织请求、取得响应、完成转换,然后把对象交给检查函数;后者只检查一个已经解析好的页面,不再发请求。两个函数各自有清楚的输入和职责。
检查的内容来自小叶后续会怎样使用数据。要遍历活动,items得是列表;要比较剩余名额,remaining得是约定的非负整数;要沿分页继续查询,必须能够区分有效后续位置和明确的结束标记。这里用type(...) is int核对整数,是为了不把Python中的布尔值也当成名额数量。读者应关注这些检查保护了哪一步,而不必把每一行当成新的语法课程。
没有统一规定要求所有接口都返回这些字段。例如,有些服务允许某个字段为null,有些服务把金额表示为文本。遇到不同约定,要改变解析与处理方式,不能把我们的检查函数原样套上去,再指责对方数据错误。小叶先确认约定,程序再检查对方交付的内容是否满足它,二者是先后关系。
这一页通过检查之后,我们得到了“可以按这些字段继续处理”的证据。它还不能单独证明活动资料真实、更新及时或涵盖全部项目。后两个问题需要服务对来源与时间的说明,以及下面的分页处理;数据检查有明确作用,也有明确范围。
七、取回一页,和取回完整结果
现在,小叶调用get_page({})。第一页包含001和002,next_cursor为"page2",total为3。他如果立刻筛选剩余名额,只会保留001,把第三条仍有名额的活动漏掉。
分页是服务把同一查询结果拆成若干批返回的安排。每批大小可能受传输开销或服务处理方式影响。在这个小案例中,每页最多两条是教学约定,便于看见边界。第一批交付成功,不能代替后面批次已经交付。
cursor可以译为游标,在这里表示继续取得结果的位置。小叶应当读取服务给出的值,再原样放到下一次请求中,而不要因为它恰好叫page2,就猜测真实服务一定还存在page3。别的服务可能用很长的编码文本表达这个位置。调用者需要知道怎样使用它,未必需要知道它内部怎样表示位置。
同时,查询条件要保持一致。假如第一页查询全部活动,第二页却加上“阅读”条件,那么两次请求的结果已经属于不同集合。把它们放在一起,即使每条记录都合法,也不能说得到了最初查询的完整结果。后续位置和它对应的查询条件应当一起延续。
把以下函数追加到api_client.py,保留前面的内容:
def get_all(q=""):
    params = {"q": q}
    items = []
    used_cursors = set()
    expected_total = None
    snapshot = None

    while True:
        page = get_page(params)
        if expected_total is None:
            expected_total = page["total"]
            snapshot = page["snapshot"]
        elif page["total"] != expected_total or page["snapshot"] != snapshot:
            raise ValueError("分页途中总数或快照发生变化")
        items.extend(page["items"])
        cursor = page["next_cursor"]
        if cursor is None:
            break
        if cursor in used_cursors:
            raise ValueError("服务重复给出了已使用的后续位置")
        used_cursors.add(cursor)
        params["cursor"] = cursor

    ids = [item["activity_id"] for item in items]
    if len(items) != expected_total or len(set(ids)) != len(ids):
        raise ValueError("收集数量与总数不符,或出现重复活动编号")
    return {"items": items, "total": expected_total, "snapshot": snapshot}
循环第一次发出的参数里只有q,没有后续位置。收到页面以后,活动记录追加进items。如果服务还给了下一页位置,程序把它放进同一份参数,再发请求;收到null时,Python对象中对应的是None,循环结束。
used_cursors是一个集合,用来记录已经用过的后续位置。如果服务反复给同一个位置,程序停止并说明问题,避免一直取同一页。结束后再核对收集数量和编号:总数为三,就应当有三条不同编号的记录。单看数量不够,因为把001重复取两遍再加002,也有三条,却仍然漏掉003。
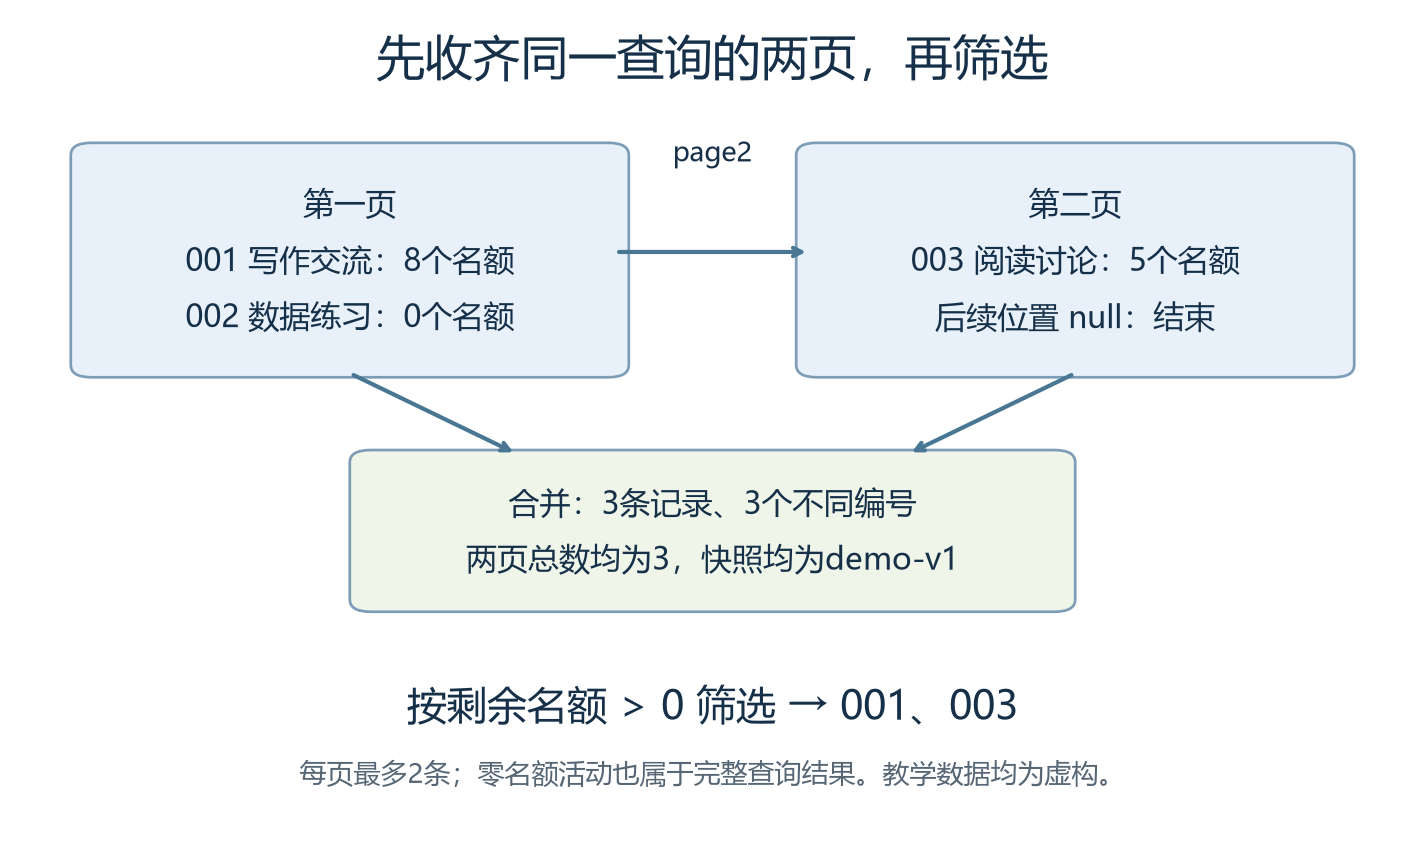
图中,第一页里那条零名额活动仍然属于完整查询结果。先收齐资料,再筛选,是因为“所有活动都取得了”和“把有名额的活动留下”是两个不同判断。如果把第一页筛剩一条,便拿这一条与总数三比较,检查的对象已经不一致。
程序还对快照标记和总数是否变化作了检查。本教学服务承诺查询期间数据固定,所以两页能够作为同一批资料合并。真实服务如果没有这种承诺,翻页期间可能有人新增或删除记录,单靠游标这个名字不能保证结果来自同一个时点。那时小叶需要查看服务对分页一致性的说明,或将结果明确标为逐页查询所得,不把它冒充某一瞬间的完整快照。
这段代码实现的是当前约定下的收集过程。数量、编号和标记检查可以发现若干常见异常,却不具备独立审计服务数据库的能力。如果服务把一条活动替换成另一条,同时保持总数和标记不变,客户端未必发现。我们相信哪些服务承诺、额外核对哪些关系,都应当对应任务对结果的要求。
八、把查询结果接到小叶自己的工作里
到这里,数据已经从服务器来到小叶的程序中,但名单还没有保存。API的价值正是在这个位置显现:服务提供结构化资料,小叶便能把它接到自己的筛选、展示或统计流程中,无须每次手工抄录网页内容。
在api_client.py同一文件夹新建save_available.py:
import json
from pathlib import Path
from api_client import get_all

result = get_all()
available = [item for item in result["items"] if item["remaining"] > 0]
document = {
    "source_snapshot": result["snapshot"],
    "queried_total": result["total"],
    "selection": "remaining > 0",
    "items": available,
}
path = Path(__file__).resolve().parent / "available.json"
with path.open("w", encoding="utf-8") as file:
    json.dump(document, file, ensure_ascii=False, indent=2)
with path.open("r", encoding="utf-8") as file:
    saved = json.load(file)
assert saved == document
print("已查询活动数:", saved["queried_total"])
print("有名额的编号:", [item["activity_id"] for item in saved["items"]])
运行后,已查询活动数是3,有名额的编号是['001', '003']。文件保存在脚本所在文件夹:__file__提供当前脚本的路径,resolve().parent取得其所在目录,后面的/把文件名接到这个目录下。这里的/用于拼接路径。代码以写入模式保存,本次运行会更新同名文件;第一次运行前若这个文件夹已有需要保留的同名资料,应换一个输出文件名。
保存的内容里特意保留了查询总数、筛选条件和来源快照。后来翻看这份文件的人就能知道:名单含两条,并不是因为只取回两条,而是从三条固定记录中筛出了两条。如果只保存最后两个名称,过程中的这些区别就消失了。保留少量与结果含义有关的信息,会帮助自己和别人正确使用结果。
assert saved == document检查保存后读回的对象与准备写出的对象是否一致。它支持“这次文件往返没有改变对象”的判断,不会自动证明名额真实,也不会替代之前的完整性检查。每一步提供自己的证据,整件事才有连贯依据。
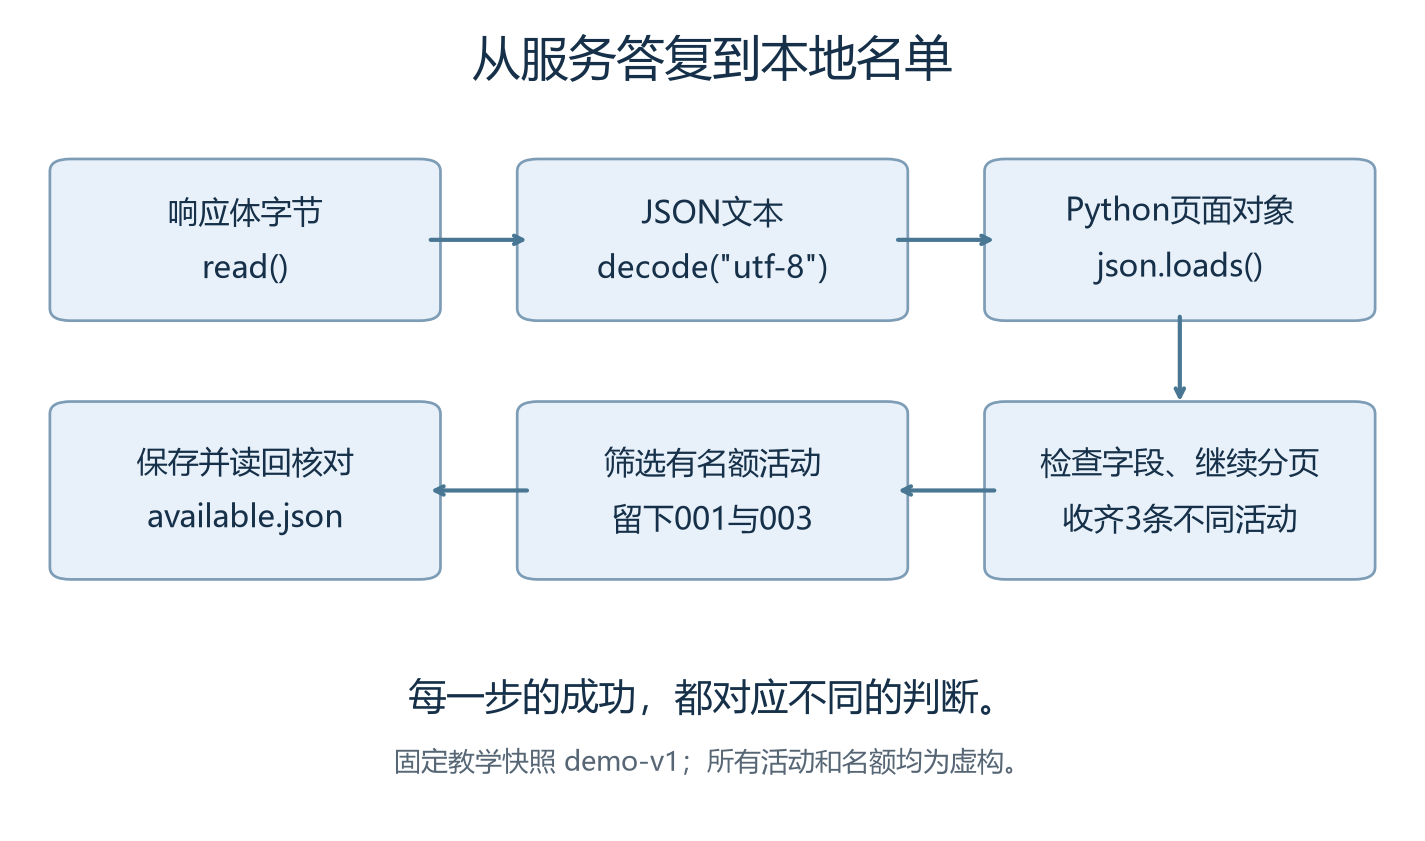
这条数据流可以在别的任务中反复出现。例如,小叶从资料服务查询文献条目,再交给AI整理主题;从订单服务取回订单,再统计需要处理的项目。服务提供数据,程序负责按约定处理,AI可以帮助解释或生成内容。各部分的能力连接起来以后,小叶仍需要决定查询范围和完成标准。
还有一种值得留意的变化:假如他希望AI为每项活动写一句推荐理由,可以把筛选后的两条记录交给AI。但活动名称和名额最好仍从原始字段取出,不让生成的推荐理由反过来改写事实字段。这样既能使用生成能力,也能保留数据原来的含义和来源。
九、查询资料之外,API还可以让服务执行动作
小叶现在有了一个新目标:先在服务端建立一份只含标题的草稿,作为以后编辑活动介绍的起点。这次提交的是标题,选出的活动内容将在以后补入。前面的查询读取资料,这次则要在服务里新增一条记录。
教学服务另提供POST /drafts入口。按它的约定,请求体应当是JSON对象,含一个非空的文本字段title;每次有效请求都新增一份草稿,并返回201状态,以及新草稿的draft_id和标题。服务刚启动时没有草稿,首份编号是D001,下一份是D002。它只在当前进程内保存,重启清空,不修改前面的三条活动资料。
这里的GET、POST是HTTP方法,用来说明本次请求希望服务怎样处理。GET用来取回资料,在本例中就是服务提供的活动信息;POST则把提交的内容交给相应入口,按该服务规定的方式处理。创建记录是POST的常见用途,但不能据此认定所有POST都只做创建,或看到同一个URL就默认操作效果相同。我们在当前服务里知道它会新增草稿,是因为接口明确作了这个约定。
请求可以携带请求体,用来传送交给服务处理的内容。前面查询用URL参数表达条件,这里则把草稿标题放进JSON请求体。请求体和响应体方向相反:前者是小叶发给服务的数据,后者是服务答复小叶的数据。两边都能采用JSON,但描述的事情不同。
将下面的代码保存为create_draft.py,放在api_client.py旁边,在服务运行期间执行:
import json
from urllib.request import Request
from api_client import BASE, OPENER

payload = {"title": "小叶的活动备选名单"}
body = json.dumps(payload, ensure_ascii=False).encode("utf-8")
request = Request(
    BASE + "/drafts",
    data=body,
    headers={"Content-Type": "application/json; charset=utf-8"},
    method="POST",
)
with OPENER.open(request, timeout=3) as response:
    status = response.status
    created = json.loads(response.read().decode("utf-8"))
if status != 201:
    raise ValueError("创建草稿未返回约定的201状态")
print(status)
print(created)
数据的转换方向与收到响应时相反:先把Python字典序列化成JSON文本,再编码成字节,作为请求内容发出。请求头的Content-Type告诉服务应当怎样解释这段内容。把字典直接放到请求体参数里,并不会让这个调用自动知道采用什么传输格式。
若服务刚启动,第一次执行得到201和包含D001的对象;再执行一次,会得到D002。两次标题虽然相同,服务仍然新增了两份草稿,因为它的约定没有把“标题相同”定义成同一次创建。201状态表示请求导致了资源创建。这个新目标也说明,前面查询函数只接受200是针对活动查询入口的判断,不能拿去拒绝所有201响应。
真实服务通常还会要求调用者提供凭据。身份认证回答调用者是谁,权限决定这个身份可以执行哪些操作。一个账号能查询公开活动,不代表它能修改活动名额;界面里能做的事,也未必自动开放给同一账号的API调用。小叶需要查看服务提供的具体权限和使用方式。
例如,一些服务要求在Authorization请求头中按指定方案提供凭据。凭据放在哪里、前面加什么标记,由该方案和服务约定决定,不能凭字段名猜测。HTTP的Authorization参考说明了这种按认证方案组织请求头的方式。教学服务没有设置认证,因此本章代码不需要真实密钥。使用真实服务时,把凭据保存在自己的配置中,避免放进准备公开的代码或作为普通案例材料交给别人。
这些知识会改变我们给AI的任务描述。让AI“查询并给建议”,和让AI“创建草稿”,已经涉及不同效果。小叶至少需要明确允许调用哪些入口、动作是否可重复,以及完成后应当检查哪个结果。接口连接的是能力,能力被怎样使用,仍取决于任务安排。
十、服务报告错误,和没有取得响应
现在把前面的查询路径故意写成/missing。本服务会返回404,并在JSON响应体里说明入口不存在。服务器已经收到请求,也作出了答复,只是答复指出这项请求不能按预期完成。
Python的urllib遇到这类HTTP错误状态,通常会抛出HTTPError。它既是一种异常,也携带服务返回的状态、响应头和响应体。所以“代码进入异常处理”并不一律等于“根本没有服务器答复”。可以在inspect_error.py中这样观察:
from urllib.error import HTTPError, URLError
from urllib.request import Request
from api_client import BASE, OPENER

request = Request(BASE + "/missing", method="GET")
try:
    with OPENER.open(request, timeout=3) as response:
        print(response.status)
except HTTPError as error:
    with error:
        print("服务返回的状态:", error.code)
        print(error.read().decode("utf-8"))
except URLError as error:
    print("未正常取得响应:", error.reason)
try中的语句先尝试执行,发生匹配的异常后,转到相应的except分支。HTTPError是URLError的子类,所以先写较具体的HTTP错误处理,再写较一般的连接等错误处理。如果把较一般的分支放在前面,它也会匹配这类HTTP错误,后面针对状态码的处理就不会被执行。异常关系及错误响应的读取方式见Python官方文档。
在本服务运行时,这个实验应显示404和错误说明。若先停止服务,客户端便无法与这个端口的服务建立正常连接,通常会进入URLError分支。两种情况下一步不同:前者已有入口错误的证据,应检查路径;后者先检查服务是否启动、地址和连接是否正确。
刚才的代码用于观察这两类情况,并没有声称捕获所有问题。收到200以后,解码、JSON解析或业务字段检查仍可能失败,它们发生在不同步骤。比如配套服务的/bad-json会返回200并声明JSON,却故意给出不完整的JSON文本;/bad-schema返回的JSON能够解析,但把剩余名额写成文本。前一种问题在解析时暴露,后一种在按本章字段约定检查时暴露。
分清阶段,不意味着每个失败都要写几十行防护代码。它首先让小叶能够保留正确的信息:服务拒绝了什么,客户端在哪一步停下,哪些结果尚未取得。后面学习调试时,这些信息会成为定位问题的材料。把各种错误吞掉,只返回空列表,会让程序表面安静,却使名单的含义变得不可靠。
十一、超时之后,为什么不能只问“要不要再来一次”
小叶向服务发送创建草稿的请求,等待了一段时间,没有得到完整答复。此时可以确定的是:客户端在设定的等待条件下没有正常完成这次等待。至于服务有没有创建草稿,还存在几种可能。
请求可能没有到达服务;也可能已经到达,服务正在处理;还可能草稿已经创建,答复却尚未被客户端完整接收。客户端看到的“超时”,不能单独把这几种情况区分开。我们需要把服务端动作和客户端获知结果的时间分开理解。
对查询请求来说,重新询问通常不会增加一份业务记录。小叶可以在确认查询允许重复、等待安排合理的情况下,再取得资料。不过,真实活动的名额可能在两次查询之间变化,因此重新查询得到的内容未必完全一样。重复操作是否引入额外业务作用,与答复文字是否相同,是两件事。
对本章创建草稿的入口来说,情形不同。它的约定是每个有效请求新增一份草稿。假如第一次已经创建成功,只是答复来晚了,第二次重新发送就会再建一份。把请求体写得一模一样,也不会自动告诉服务“这是同一次操作的补发”。我们刚才连续运行两次创建脚本得到D001和D002,已经看到了这个规则。
理解这种区别时,会遇到幂等这个词。在HTTP方法语义里,幂等关注的是:多次相同请求对服务器产生的预期效果,与执行一次相同请求的预期效果是否相同。它不要求每次响应内容逐字相同,也不要求服务器完全不记录日志。GET属于幂等方法;POST本身没有提供同样的通用保证,具体操作可能通过额外约定支持安全重试。相关定义和重试条件见HTTP语义规范。
可以用另一个假设帮助理解。有个服务允许“把某份草稿的状态设置为待审核”,并且约定重复设置不会再次触发其他业务动作。执行一次以后,状态是待审核;重复执行,预期效果仍是同一状态。相比之下,“新增一份草稿”每执行一次都会增加记录。区别来自动作怎样改变服务里的状态,并不来自请求看上去有多简单。
如果小叶确实需要可靠地重复提交创建请求,服务可能提供一种“请求标识”的约定:客户端为同一次业务操作提供同一标识,服务在规定范围和有效期内识别重复提交,返回已有操作的结果。只有服务明确支持并说明这些规则时,客户端才能依靠它。自己随便加一个叫idempotency_key的字段,而服务根本不处理它,并没有改变创建行为。
教学服务没有实现这种重复识别。为了观察结果,配套服务还提供GET /drafts,返回当前进程中已经创建的草稿。在这个只有自己操作、初始状态已知的教学实验里,发生创建超时后,可以查询草稿列表来观察服务是否留下记录。真实多人系统中,仅凭相同标题往往无法唯一对应一次操作,还需要服务支持的操作编号或查询方式。
于是,“要不要重试”应当拆成一个具体判断:这次请求会做什么,重复做会增加什么作用,能否确认上一轮结果,服务有没有为重复提交作出保证。至于重试间隔、次数上限和完整恢复流程,可以在后续工程课程中进一步学习。本章先建立这个依据,避免让AI在任何异常后都自动重新发送同一动作。
超时也不意味着应当无限延长等待。如果服务没有运行,等得更久并不会使它自己启动;如果一次创建结果不明,延长下一次请求的等待也没有消除重复创建的可能。处理办法要对应当前缺的信息和动作效果,这样才能从“程序没成功”走到有依据的下一步。
十二、现在可以怎样安排AI参与这件事
回到开头,小叶要给同学一份可供挑选的活动名单。我们现在能具体说明这项工作怎样完成:客户端按约定查询固定快照,沿后续位置取回两页,核对三条记录的范围和编号,留下001与003,再保存来源标记和筛选条件。读回文件确认对象一致以后,他能够解释名单为什么是两条,也知道这一步没有替同学完成报名。
这时,AI可以承担不少工作。它可以根据接口文档生成请求代码,把分页和字段检查接起来,也可以根据活动资料写说明。小叶提供给它的有效信息,是目标、接口约定、真实可用的字段样例,以及完成后怎样核对。单纯说“你是一位资深程序员,请高质量完成”,并没有补足这些信息。
例如,如果AI给出的方案只取第一页,小叶能够直接指出遗漏发生在收集阶段;如果它收到异常就返回空数组,他能指出失败被伪装成正常空结果;如果它准备给创建草稿加自动重试,他能要求先说明重复请求的效果。这些判断都来自对程序协作的理解,无须先把所有网络协议学完。
阅读AI写的代码时,也可以沿数据流提出问题:这里还是字节,还是已经解析好的对象?当前列表是一页还是全部?这个字段来自服务,还是AI根据上下文生成的描述?这一次请求只取资料,还是会在对方系统留下记录?问题具体以后,代码和业务目标便能相互核对。
本章的学习结果,不是背下某个服务的一套字段。换一个API,字段名、认证方式和分页安排可能都变;仍然有效的是这条理解路径:先明确协作约定,观察请求和响应,再把数据的形态、范围与任务作用接起来。小叶借助AI写程序的速度可以很快,但这条路径让他知道程序正在完成什么,也能发现它在哪一步还没有完成。
练习与参考分析
练习一:成功响应中的空列表
小叶向教学活动接口查询名称包含“音乐”的活动。服务正常返回200,响应体能够解析,items为空,total为0,next_cursor为null,快照标记仍为demo-v1。这能不能作为正常结果?能否据此宣布学校没有音乐活动?
参考分析: 按本章固定的三条记录,确实没有名称包含“音乐”的项目。请求成功与结果为空可以同时成立。检查函数接受非负整数总数零,分页函数取得空列表后到达末页,记录数也与总数相符,不需要编造一条活动来使结果“看起来成功”。
但结论范围是这个服务、这个快照和这个名称筛选条件。它没有覆盖学校所有现实活动,也没有识别名称中未出现“音乐”却实际与音乐有关的项目。小叶可以说“这份资料中没有名称包含‘音乐’的记录”。如果目标改为了解学校实际全部音乐活动,需要扩大资料来源或重新定义检索条件,不能由这一次空结果直接下结论。
练习二:同样是200,失败发生在哪里
有两份响应都带200状态和JSON内容类型。甲的响应体只有{"items":;乙的响应体是完整JSON,活动字段remaining的值为"8"。按本章程序,这两份资料分别在哪个阶段无法继续?如果另一条活动记录根本没有remaining字段,直接补成零是否合适?
参考分析: 甲缺少JSON结构所需的后续内容,按UTF-8解码为文本以后,json.loads无法完成解析。乙可以解析,解析出的剩余名额是字符串,按本服务要求整数的约定,validate_page应当拒绝。两者都不是“服务里没有活动”,也不是已经取得可直接筛选的记录。
把缺失字段填成零,会把“没有得到名额资料”变成“明确没有名额”。除非服务约定缺失就是零,否则这种处理改变了信息含义。若另一接口正式规定名额用数字文本传输,可以按它的规则转换并检查;这里判断乙不合约定,并不是说所有JSON数字文本都不能使用。
练习三:总数相同,为什么仍可能漏项
某次收集中,第一页返回001和002,第二页又返回002。两页都说总数为3、快照为demo-v1,第二页表示结束。小叶数了数,列表长度正好是3,准备开始筛选。检查还缺什么?如果他直接去重以后交付,又有什么问题?
参考分析: 三条列表元素不等于三个不同活动,编号002重复了。按固定教学资料,003尚未取到。get_all同时比较记录数量和不同编号数量,能够发现这个异常,停止交付,而不是只接受总数相同。
去重会留下001和002,重复表象消失,但漏项并没有补回。小叶仍需要查明分页结果为什么重复,取得缺失记录,或明确报告未取得完整名单。尤其003还有剩余名额,如果直接交付,最终可选活动就会被少报。这里检查编号的意义,是保护完整收集这个目标,不只是让列表看起来整齐。
练习四:查询条件中出现特殊字符
小叶接到一段活动名称关键词:写作 & 表达。他打算直接把它拼在/activities?q=后面。为什么应当改用urlencode?正确编码以后,服务一定会找到活动吗?
参考分析: 查询字符串用特殊字符组织结构,原始关键词里的&若直接进入字符串,可能被理解成参数之间的分隔。编码函数会把这一整段内容作为q的值表达出来,使解析方能够恢复原本关键词。要保留的是条件的含义,不能为了避开字符问题把关键词随意改成别的词。
正确表达条件,并不保证资料里有匹配对象。教学服务按完整文本的包含关系筛选,它的三条名称都不包含写作 & 表达,因此应返回正常空结果。编码解决传达条件的问题,是否匹配取决于资料和查询规则。把空结果都归因于编码错误,同样混淆了不同阶段。
练习五:请求超时,草稿却已经存在
教学服务刚启动,还没有草稿。小叶提交一次有效创建请求,服务新增了D001,答复传回前客户端等待超时。这里题目已经明确服务完成了创建。小叶原样重发一次且得到正常答复,会有几份草稿?若改用另一个明确支持重复请求标识的服务,是否必然仍是这个结果?
参考分析: 当前教学服务每个有效POST都新增一份记录,没有重复识别。第一次已经创建D001,第二次会创建D002,共两份。超时没有撤销已经发生的动作;标题和请求体相同也没有使第二次请求变成第一次的结果查询。
另一服务的结果要按其约定判断。如果它明确支持在有效期内用同一请求标识识别同一创建操作,小叶又正确使用相同标识,那么重发可能返回已有结果而不新增。若标识换了、有效期已过或请求内容不符合重复处理规则,就不能沿用这个保证。关键在服务实际承诺了什么,不能只看到“POST”便宣布一律可重试或一律不能重试。
练习六:已经拿到名单,任务是否完成
AI帮小叶取回全部三条活动,筛出了001和003,控制台打印了两个名称。小叶的原目标还包括保存可核对名单。AI据此说“活动推荐任务已全部完成”,这个结论缺什么依据?现在让它继续为两项活动写介绍,应怎样保留事实与生成内容的关系?
参考分析: 查询和筛选已经有相应结果,但打印不能证明文件已经保存,也没有给后来阅读的人留下来源快照与筛选条件。还应按原目标写出文件,读回核对对象,并保留足以解释结果范围的信息。是否完成要与开头的交付标准比较,不能只因控制台有内容就提前结束。
生成介绍时,可以让AI根据这两条记录写说明,并把生成文本存为独立字段。编号、活动名称、剩余名额继续来自查询资料,避免AI把猜测写回事实字段。如果介绍需要课程难度、场地或报名截止时间,而原资料没有提供,就需要补充来源或收窄介绍内容。这样使用AI扩展表达能力,同时让最终结果仍然能够追溯到已取得的数据。