一、两种结果,到底哪一种偏差更小
小叶正在制作一块校园活动展板,让AI协助检查排版程序输出的位置。展板上有四条竖向定位线,它们的横坐标决定四组内容从哪里开始。为了单独研究位置偏差,这一轮只检查四条线的横坐标,文字内容、颜色和印刷质量另行处理。
坐标从固定画布原点向右增加,统一用毫米记录。四条线按编号排列,目标位置是t=(0,100,200,300)。两段程序交出了以下结果。表中数字是为讲解设定的,并非真实印刷测量。
| 定位线 | 目标位置 | 程序甲的输出 | 程序乙的输出 |
|---|---|---|---|
| 第1条 | 0 | 3 | 1 |
| 第2条 | 100 | 100 | 101 |
| 第3条 | 200 | 200 | 201 |
| 第4条 | 300 | 300 | 301 |
甲只有一处错了,但那处向右偏了3毫米;乙四处都向右偏了1毫米。小叶问AI:“哪一个更准确?”一种回答认为甲只有一处偏差,应该选甲;另一种回答认为乙没有特别大的错误,应该选乙。
这两个回答关注的东西不同。小叶需要先说清这次验收:任何一条线都不能偏离目标超过2毫米;满足这个条件以后,再用本讲将介绍的L2范数比较四处偏差的整体大小。 前半句是逐处必须满足的要求,后半句才是合格结果之间的比较。一个综合数字不能自动代替两种判断。
先把输出减去目标,得到误差向量。设程序输出为p,本章统一用e=p−t;正数表示偏右,负数表示偏左。甲、乙的误差分别是:
两份误差向量中,同一位置的分量对应同一条定位线,记录其毫米偏差。这是四分量的数据表示,不是说一块展板有四个物理空间方向。把四个位置一起记录,方便我们比较一整份结果。
本讲会把三个概念连起来:范数把一份向量的大小记成一个数,内积描述两份向量的分量怎样共同作用,距离则衡量两份表示之间的差别。学到最后,我们应能解释为什么换一种大小规则会改变选择,为什么方向相近不等于位置准确,以及AI写出的几行比较代码究竟在比较什么。
二、把偏差看成整体,为什么不能直接相加
正负可以抵消,错误却未必消失
若另外一份输出让第1条线偏右2毫米、第2条线偏左2毫米,误差就是(2,−2,0,0)。四个分量直接相加为零,但两条线都没有回到目标位置。这个零说明左右偏移在总和中抵消,并不说明排版没有偏差。
有符号求和也有用途。例如,把四处误差求平均,可以观察这一组位置是否整体偏向一边。但当问题变成“每处究竟错了多少”,我们需要把向左、向右的偏差都算进去。评价整体偏差与观察平均偏移,是对同一份数据提出的不同问题。
一种熟悉的做法是先平方再相加,最后开平方。二维位移(3,4)的长度为5,来自直角三角形的勾股关系。推广到n个实数分量,就得到欧几里得范数,也叫L2范数:
这里n是参与比较的分量数,双竖线表示取范数,右下角2表示采用平方和这一种规则。n与2承担不同作用:四处分量的数据也可以取L2范数,不是只有二维向量才能使用它。
平方让正负偏差都贡献非负数量;相加把各处偏差合并;开平方使最后结果回到原来的量纲。主案例每项是毫米,平方和是平方毫米,L2范数重新以毫米表示。如果只保留平方和,它仍可作比较指标,但不能把数值直接当成毫米长度。
甲的L2范数为3毫米,乙为2毫米。乙有四个1毫米偏差,平方合计为4,再开平方得到2。这不表示展板上有某一条线恰好偏了2毫米;它是四处分量按指定规则合成的大小。
为什么这一规则更在意集中出现的大偏差
平方和里,一个3毫米偏差贡献9平方毫米,四个1毫米偏差合计贡献4平方毫米。因而当前比较更不喜欢甲那处集中的大偏差。关键不在于算术复杂,而在于它对偏差分布的处理方式:某处偏离目标越来越远,会让平方项增长得越来越快。
例如,一处偏差从1毫米增加到2毫米,平方项增加3;从2毫米增加到3毫米,平方项增加5。这里增加的不是同等大小的“每毫米代价”。使用平方误差时,我们已经对大偏差给予了更强的关注;这是否符合任务,要由实际验收需要决定。
L2范数不会保存偏差发生的具体位置。把(3,0,0,0)的3移到另一个分量,范数仍为3。如果第一条线与第四条线的重要性不同,当前这把尺子还没有表达这种差异。范数能提供概括,也会省略信息,所以原误差向量仍值得保留。
总体大小与每处分量的典型大小
如果把同样的四处数据复制成八处,L2范数会增加,即使每处偏差没有恶化。全为1毫米的四分量向量范数是2毫米,八分量向量则是√8毫米。它累计了更多分量的平方,并不说明单处质量变差。
要按分量数作平均,可以计算均方根误差,常记为RMSE:
甲的RMSE为1.5毫米,乙为1毫米。对同样四处位置,比较L2、平方和或RMSE,排序一致,因为它们之间只相差单调变换和共同常数。分量数量不同以后,L2与RMSE的排序就不一定一致。例如,把同一份数据重复记录一次,L2会增大,RMSE却保持不变。若要比较不同记录,还需核对抽查位置和权重是否一致,才能判断分数差别来自实际偏差,还是来自记录方式。
RMSE也不能替代逐处限值。甲的1.5毫米低于2毫米,但第1条线仍偏了3毫米,违反原验收。这个例子使我们看到:平均意义上的不错,与每个位置都合格,并不是一回事。Boyd与Vandenberghe教材第3章讨论了范数、均方根与距离的基本联系。
三、内积怎样解释两次变化会相互加强还是抵消
从成对分量的共同贡献开始
对于分量数相同的实向量u、v,标准内积定义为对应分量相乘再求和:
也常把它叫作点积。结果是一个数,不再是一份n分量向量。前一讲的矩阵乘法中,一行与一列组合成一个输出元素,就使用了这种运算。对应位置必须代表可以配对的字段,不能只因数组长度一样便不加解释地相乘。
在同一种位移或误差表示里,一对分量同号时乘积为正,异号时为负,一方为零时没有贡献。求和让我们看见两份变化在共同分量上总体怎样配合。某些方向的加强与另一些方向的抵消,可以同时发生。
内积不总是在算“相似程度”。如果一份向量记录各类物品数量,另一份记录各类单价,对应相乘再加起来算的是总价。运算结构相同,含义来自分量所代表的对象。我们接下来讨论长度与方向时,使用的是同一空间内的两份向量,不能把价格与数量的总价解释强行搬过来。
同样大小的修正,效果为什么不同
小叶准备调整程序甲。原误差e=(3,0,0,0),一种调整让第1条线向左1毫米,同时让第2条线向右1毫米,其余不动。把这次位置变化记为c=(−1,1,0,0),调整后的误差为e+c=(2,1,0,0)。
这一调整减轻了原来最突出的偏差,也在另一处引入了小偏差。新L2范数为√5毫米,小于原来的3毫米。若另一次调整让两条线都向右1毫米,即c′=(1,1,0,0),调整量本身的L2范数同样是√2毫米,却会把误差变成(4,1,0,0),范数增大到√17毫米。
两次调整的大小相同,效果却相反,原因在于它们与已有偏差的方向关系不同。把平方和展开,可以把这层关系记成:
右边有三部分:已有偏差的平方大小、两份变化共同作用的部分,以及调整自身的平方大小。各个(eᵢ+cᵢ)²展开后出现2eᵢcᵢ,把这些交叉项相加就得到2⟨e,c⟩。这一项让“向哪里改”进入了总误差,而不只是问“改了多少”。
向左修正时,e与c的内积为−3平方毫米,因此新平方误差是9−6+2=5;同样大小的向右调整使内积变成正3,得到9+6+2=17。少量计算对应的是一个直接判断:原来偏右的地方,再向右推会放大偏差,适当向左推能够缓解它。
不过,内积为负也不保证最终改善。若把第1条线一下向左移动7毫米,误差会由偏右3毫米变成偏左4毫米,反而更大。调整方向对了,幅度仍可能过头。上式中调整自身的平方项保留了这一代价,不能只看交叉项为负就省略它。
内积的规则为什么值得认识
实向量标准内积交换两项不变,对相加和倍乘可以分开计算;向量与自己的内积非负,且只有零向量才得到零。这些性质把刚才的平方展开接在一起,也使范数可以写成√⟨e,e⟩。
把一个输入固定,内积对另一个输入是线性的。例如,已有偏差e固定时,两次调整c、d分别带来的交叉贡献可以相加。但如果两项都同时放大两倍,内积会放大四倍。所谓“对每个输入分别线性”,不等于把两个输入一起看时仍按同一个倍数变化。
本讲使用实数。处理复数向量时,需要在一侧取共轭,才能让自身内积正确表示平方大小;不同教材和接口的共轭约定也应看清。当前位置偏差都是实数,不需要先学完整复内积理论才能继续。
四、从内积读出方向,还要先考虑长度
一份向量沿指定方向有多少分量
先用一个二维位移帮助观察。位移u=(3,4)表示向右3毫米、向上4毫米,长度5毫米。横向单位方向a=(1,0)与u的内积为3,读出沿横向的有符号分量;纵向单位方向(0,1)则读出4。
这里的单位方向只规定方向,长度取1,不再携带一份额外的实际毫米位移。u与它做内积,结果仍可解释为沿该方向的毫米分量。如果把参考向量写成(2,0),内积会变成6,这时参考向量的长度也参与了放大,便不能直接把6当作原位移的横向长度。
所以,当我们想单独研究方向关系时,要把两边原有的长度影响分开。对非零向量u、v,夹角θ满足:
平面里,这个式子可以理解为一份向量沿另一份方向的有符号分量,再乘参考向量的长度。推广到更高维,就用同样的关系定义夹角;不必先在脑中画出四维展板。这里的“方向”是四处分量的组合方式,不是又增加了一个实际空间朝向。
同向时余弦为1,反向时为−1,垂直时为0。非零向量的内积为正,夹角小于90度;为负,夹角大于90度。它表达总体关系,而不是要求每一对分量都同号或都异号。比如(2,1)与(2,−1)第二处分量反号,但内积仍为3。
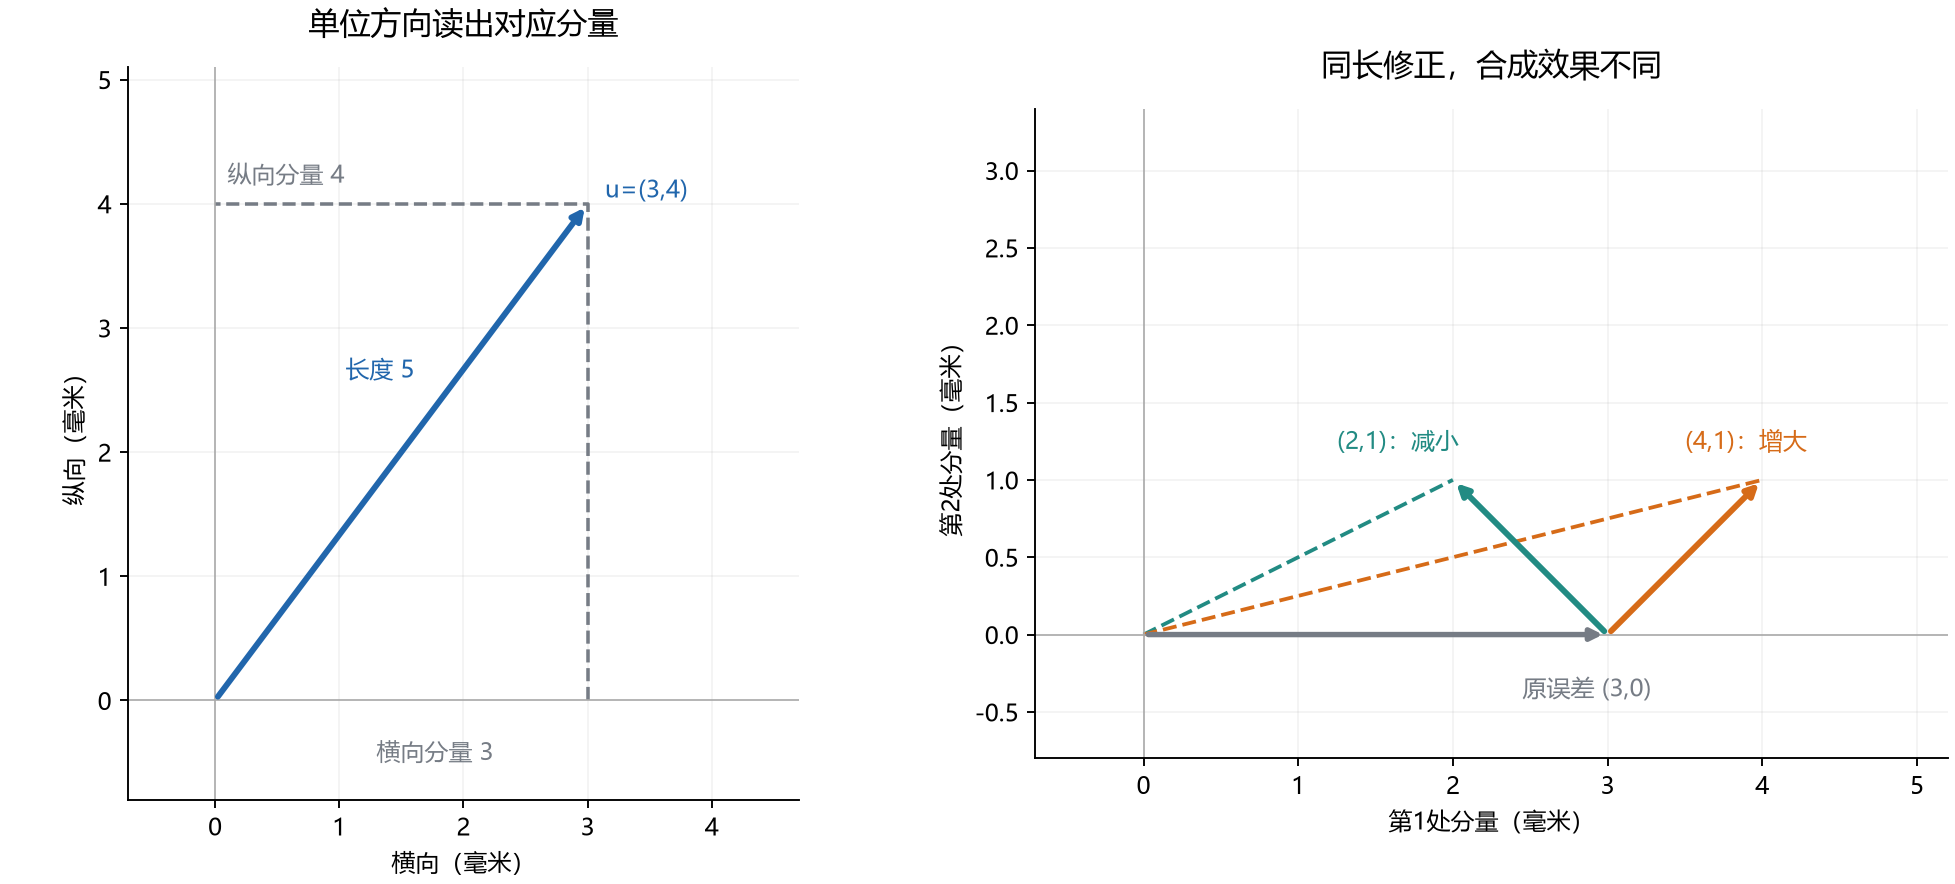
图一:左图显示二维位移(3,4)及其横、纵分量,单位为毫米。右图仅画甲误差和两种调整中前两个分量,其余两项始终为零;同样长的调整可以减小或增大合成误差。
正交不等于两份数据没有任何关系
内积为零时,称两份向量正交。在普通平面位移中,它对应垂直;在四分量或更长的数据中,它指按当前内积计算,成对贡献的总和为零。
比如u=(1,1)、v=(1,−1)的内积为零。两者并没有使用互不重叠的分量,恰恰在两个位置上都有值,只是正负贡献抵消了。对于正交向量,合成后的平方范数等于各自平方范数之和,因为前一节的交叉项消失了。
零向量与任何向量的内积都为零,因此按代数定义也正交。但零向量没有可指定的方向,不能给它计算一个通常意义的夹角。这两个说法并不冲突:正交的代数条件适用于零向量,夹角公式则需要两边范数非零。
此外,向量正交不是概率论中的统计独立。即使把两列中心化数据的内积看成某种经验相关的依据,零相关也不能推出独立。这里观察的是指定表示及内积中的关系,没有自动证明两项现实过程互不影响。概率课程的“独立”问题需要概率分布和额外条件。
内积的大小为什么受两份向量的长度乘积约束
柯西—施瓦茨不等式给出一个基本界限:
在平面里,它说明一份位移沿某个方向的分量,其大小不能超过位移本身的长度。两份向量的长度固定时,完全同向或反向达到这个界限;偏离这两种方向,内积绝对值便受到限制。
也可以直接从非负平方验证它。令u非零,把v减去沿u的一份倍数,任何这样的剩余向量都有非负平方范数。取倍数α=⟨u,v⟩/‖u‖₂²,展开后得到‖v‖₂²−⟨u,v⟩²/‖u‖₂²≥0,整理就是上面的不等式。这里无需提前解完整投影问题,只用了平方范数不能为负。
因此,把内积除以两边长度后,结果落在[−1,1],夹角公式才有意义。这个界限也能用来检查程序输出:若声称算的是这组实向量的标准余弦,却明显超过范围,应检查计算定义或数据;浮点舍入造成的极小越界则要与真正的实现错误区分。TU Delft的内积章节给出了这些几何关系与不等式。
五、范数不止一种,因为“整体大小”可以有不同含义
L1关注偏差总量,L∞关注最突出的一处
回到四条定位线。除平方和之外,也可以把各处偏差取绝对值后相加,得到L1范数;或只取最大的绝对偏差,得到L∞范数:
无穷符号在这里是这一类范数的名称,不是说输出数值变成无穷。对一份有限实数记录,它就是查看最突出的那个分量。三种规则用于主案例,得到:
| 比较规则 | 程序甲 | 程序乙 | 当前数值较小者 |
|---|---|---|---|
| L1:绝对偏差相加 | 3毫米 | 4毫米 | 甲 |
| L2:平方和开平方 | 3毫米 | 2毫米 | 乙 |
| L∞:最大绝对偏差 | 3毫米 | 1毫米 | 乙 |
L1把每处增加的1毫米绝对偏差同样计入总量,不会因为原来那处已经偏得较多,就单独提高这1毫米的权重。L2通过平方更强调集中出现的大偏差。L∞只看最突出的一处,其他位置只要没有超过它,就不会改变当前最大值。
例如,一份误差从(3,1,0,0)改善为(3,0,0,0),第2处已经对齐,但最大偏差仍为3毫米,L∞没有变化。这个指标适合检查“最差的一处不能超过多少”,却不负责保存所有小改进。
小叶的逐处2毫米要求,正好可以写成‖e‖∞≤2毫米。这是原要求的紧凑记录。若只看L1,可能因为甲总偏差小就把它选入;但甲的最大偏差已经不合格,综合比较应在这一步之后进行。
同一个上限,在不同规则里圈出不同范围
为了画图,暂取只有两个偏差分量的情形,并把共同上限设为1。L1不超过1时,两项绝对偏差共用同一份总量;一项绝对偏差增加,就会减少另一项可用的余量。L2不超过1时,允许范围是圆盘。L∞不超过1则分别约束两项都在−1与1之间,允许范围是正方形。
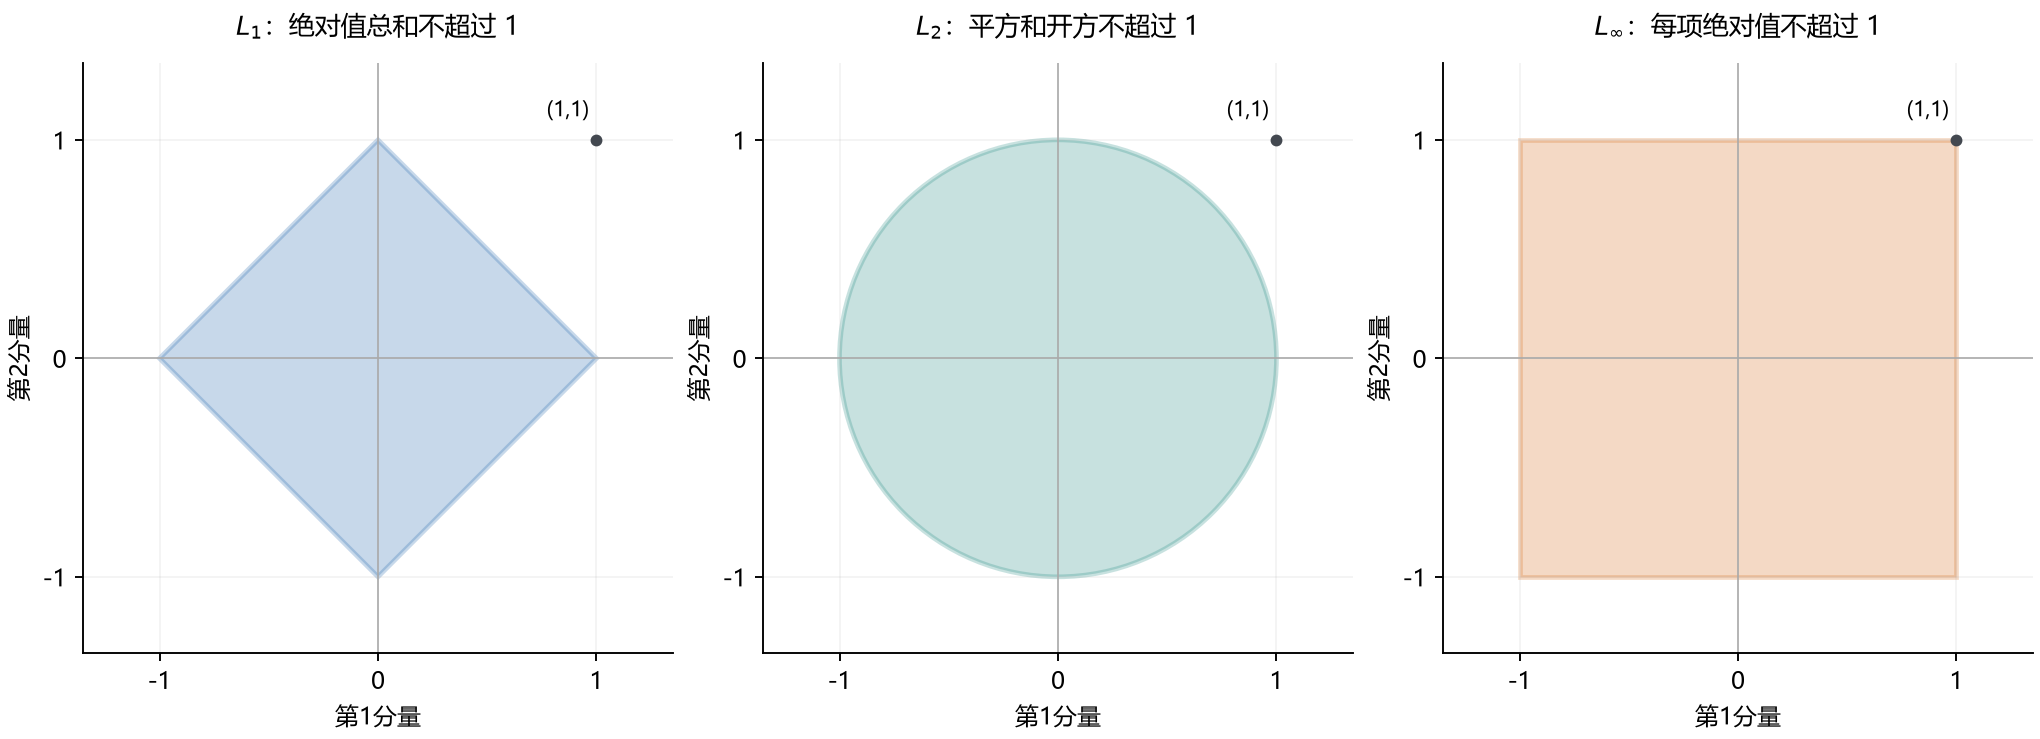
图二:三图使用相同坐标尺度,阴影分别表示对应范数不超过1的全部误差。图中只画两个无量纲分量,用于比较三种规则的几何差异,并非把主案例缩成只检查两条线。
例如(1,1)在L∞规则下恰好达到上限,在L2与L1规则下却超出了1。它不是忽然变成了另一份误差,而是三种规则对多处分量同时出现偏差的处理不同。图形让我们看见:选择一个范数,也是在选择哪些误差组合被同一个数值上限接受。
什么样的大小规则才叫范数
一种函数要作为范数,需要保留几条基本的“大小”关系:结果非负,且只有零向量大小为零;整份向量放大a倍,大小放大|a|倍;两份向量相加后的大小,不超过各自大小之和。最后一条称为三角不等式:
负倍数只翻转方向,所以范数使用绝对值;三角不等式允许方向抵消,却不允许两次变化合成的大小超过把各自大小完全相加。例如,向右3毫米再向左1毫米,净位移为2毫米,不是4毫米。各自大小相加仍可给出一个保守上界。
对于L1,逐处分量使用|uᵢ+vᵢ|≤|uᵢ|+|vᵢ|,再相加即可得到这条关系;L∞也可从每一处分量的上界得到。L2则可把平方展开,再用前面的内积界限控制交叉项。三种形式不同,但都保留了这一组大小关系。
不是一切叫“范数”的程序选项都严格满足这些条件。经常见到的“L0范数”统计非零分量数量,把(1,0)放大成(10,0),计数仍为1,没有按十倍变化,因此严格说不是范数。它可以帮助描述有多少分量被使用,但不能因为沿用了名称,就把范数的所有性质直接套给它。
范数之间也能建立界限。对n分量实向量,有‖e‖∞≤‖e‖₂≤‖e‖₁,并且‖e‖₂≤√n‖e‖∞。平方和包含最大绝对偏差的平方,因此L2不会小于L∞;各项平方又都不超过这个最大平方,把至多n项相加再开方,就得到后一个上界。它们能帮助判断一个条件是否足以保证另一个条件,却不表示可以保留同一个阈值而随意互换规则。《动手学深度学习》的线性代数部分介绍了常见范数及其基本性质。
六、距离衡量两份结果的差,不是它们各自的大小
先做差,再用已经选好的尺子
给定同一种范数,两份向量p、q之间的距离可以定义为:
范数先接收一份向量,距离则接收两份表示。小叶比较输出与目标的位置误差,正是在计算它们的距离。甲、乙的误差方向可能不同,但只要范数固定,距离计算的含义就明确。
一份向量的范数可以看成它到零向量的距离。不过,“输出坐标本身的范数小”通常不等于“输出准确”。目标位置并不全为零,若程序把四条线都放在画布原点,输出范数确实变成零,排版却完全没有完成。
换一个共同画布原点时,目标和输出都会加上同一份坐标偏移,做差以后这份偏移抵消,位置误差保持。例如同时把每个坐标加1000毫米,不应让两段程序突然显得不准确。直接比较绝对坐标的长度或夹角,则可能受记录原点影响,这正是要先明确比较对象的原因。
由范数得到的距离具有对称性,两份表示相同才距离为零,并满足距离形式的三角不等式。它意味着经过中间表示r来比较,p到q的距离不会超过p到r与r到q的距离之和。这里是对数据表示之间差别的约束,不自动等于人在校园里的可通行路线长度。
平方距离保留某些排序,但不保留所有距离性质
许多程序为减少一次开平方,直接比较欧氏距离的平方。如果只是对同一个目标,把各候选按远近排序,平方是严格递增的,所以与比较距离得到相同排序。这时可以省略开平方,但输出的量纲和阈值也必须同步处理。
例如距离要求不超过2毫米,对应的平方距离要求不超过4平方毫米。如果把平方距离与数值2直接比较,验收条件就已经变了。这不是显示格式上的差别,而会影响哪些候选被保留。
平方欧氏距离也不满足通常的三角不等式。在实数轴上,0到2的平方距离为4,0到1与1到2的平方距离相加却只有2。因此,能保持最近候选的排序,不表示它仍具有真正距离的全部性质。某个推理若用到了三角不等式,就不能不加检查地换成平方距离。
还有一种常见混淆:对每个样本分别平方不改变大小顺序,并不意味着把多个样本的平方再相加以后,所有候选的排名仍与“距离相加”一样。求和以前怎样处理每项,会改变对大偏差的重视程度,这正是L1与L2在主案例里选出不同结果的原因。
七、比较尺度没有确定,距离数字就还没有确定含义
换一个计量单位,为什么不该改变判断
主案例四处分量都用毫米,直接比较尚有共同尺度。但AI处理的记录常包含不同单位。例如,另一项展板交付检查同时关注交付时间和一处位置,某方案的偏差为10分钟与1毫米,另一方案为2分钟与3毫米。
若直接把数字写成(10,1)、(2,3)计算L2,前者约10.05,后者约3.61,看起来后者更接近目标。现在只把时间从分钟改成小时,记录变为(1/6,1)、(1/30,3),算出的L2约为1.01与3.00,排名反了。
两份实际交付没有发生变化,只是时间单位变了。问题在于第一次运算直接把以分钟和毫米记录的数平方相加,没有解释两类偏差之间的比较标准。改成小时以后,时间项的数值缩小了,位置项却没有变,等于悄悄降低了时间偏差在总分中的作用。
一个可解释的办法是先给每类偏差约定比较尺度。例如,以10分钟为一份时间偏差,以1毫米为一份位置偏差。两份记录变为(1,1)与(0.2,3),此时分量都表示“相对于本项尺度有多少份”,不再带分钟或毫米单位。
按这个约定计算L2,前者为√2,后者约为3.01。若时间改用小时,比较尺度也同步改为1/6小时,两个比值就完全不变。我们不是为了得到某个排名而选单位,而是把原来隐含的比较标准写清,让单位变化不再偷改规则。
这里的10分钟和1毫米是本例事先设定的尺度,不是数学自动给出的最优标准。它们可以来自允许偏差、测量分辨率或已经确认的业务代价,但这些来源含义不同。用样本标准差作尺度,表示按数据的波动程度缩放,也不能直接等同于按任务重要性加权。
除以容许尺度,等于让各分量使用不同刻度
设各分量的正尺度为s₁到sₙ,可以定义:
若eᵢ与sᵢ采用同一单位,结果没有量纲。某处分量的尺度越小,同样实际偏差会占据越多份额,因此受到更强关注。这个规则相当于先缩放各轴,再取标准L2范数。
假如换到另一份任务,四条线的容许偏差分别是(3,1,1,1)毫米,甲的归一尺度误差为(1,0,0,0),乙为(1/3,1,1,1)。按这个新规则,甲的L2为1,乙为√28/3,约1.76,甲反而较小。这里采用的是另一项任务的容许偏差,比较标准已随任务改变,不能把新的选择当成原来逐处2毫米要求下的结果。
还要区分综合尺度与逐项限制:要求每处都在自己的容许范围内,对应maxᵢ|eᵢ/sᵢ|≤1;要求归一尺度L2≤1则更严格,因为几处各自接近上限时,平方和可能已经超过1。乙在这个新例中每处都没有越过各自上限,综合L2却大于1。究竟采用哪种要求,不能让程序默认替我们决定。
写成加权平方和时,权重为wᵢ=1/sᵢ²。只要这些尺度都为正,变换可逆,便仍定义了一种范数。若把某一项权重设为零,两个只在那一项不同的向量会得到零距离;这可能符合“忽略该字段”的意图,却已不能在原来的全部字段上区分不同记录。
一个重要的使用习惯由此形成:看到距离分数,先看字段、单位、缩放与权重。比较规则是否表达了真正重要的差别,要回到这些设置判断;增加分数的小数位,并不会改变它关注了哪些差别。
八、坐标可以换,原来的长度不能靠猜
正交单位基为什么让公式格外简单
前面二维位置的横纵轴互相垂直,刻度长度一致。于是把系数平方相加再开平方,就得到以该长度单位表示的实际位移长度。若改用斜着的基向量,同样的“分量平方和开平方”一般不再直接代表原空间的物理长度。
设平面仍用原横纵坐标测量,另选两支基b₁=(1,0)、b₂=(1,1)。它们线性无关,能够表示全部平面位移,但不垂直,第二支也不是单位长度。这里的数值都采用同一个固定长度单位。
实际向右一个单位的位移u=(1,0),新坐标仍为a=(1,0)。实际向上一个单位的位移v=(0,1),却要写成−b₁+b₂,新坐标为b=(−1,1)。如果直接对两份新坐标做标准内积,得到−1;直接取b的L2,则得到√2。可实际的两支位移本来垂直,长度也都是1。
错误不在换基。新坐标仍准确记录了原对象;遗漏的是新基各自的长度,以及基之间不垂直的关系。要保留原来的测量含义,可以先把坐标还原回原表示,再计算。
把基之间的关系一起记录
把两支新基按列组成B=[[1,1],[0,1]],实际位移分别为Ba、Bb。原内积就成为:
G的每个位置记录一对基向量的内积:对角位置记录各基的平方长度,非对角位置记录不同基方向的共同贡献。它常称为格拉姆矩阵。这张矩阵补回了新坐标本身没有显示的几何刻度。
对于刚才的a、b,aᵀGb=0,bᵀGb=1,于是得到实际正交、长度为1的原结果。不需要规定所有基都必须垂直才能使用,只需把使用哪种内积这件事说明白。只有基互相正交且每支长度为1时,G才是单位矩阵,熟悉的直接点积就无需额外调整。
这也解释了A04中的不同变换。共同旋转所有向量时,Q满足QᵀQ=I,所以标准内积及L2长度保持;单独把横向拉伸两倍,矩阵S的SᵀS却为diag(4,1),原横向差别被放大,通常会改变长度和角度。
一个AI程序把数据乘了矩阵以后,不能仅凭“只是线性运算”就宣称距离不变。我们要分清:它是在改变对象,还是在改变记录坐标;比较时采用的几何刻度有没有相应调整。本节只用一个平面例子说明这个关系,更完整的投影与分解留到后续章节。
九、归一化可以留下方向,也会主动舍去大小
单位向量怎样得到
对非零向量x,用它除以自身L2范数,得到同方向、长度为1的向量:
例如(3,4)变成(0.6,0.8),各分量比例保留,整体长度变成1。原向量放大成(6,8)后再归一化,也得到相同结果。这正是操作的作用:把同一方向上不同长度的记录归到一起。
当长度本来不重要时,这样做很有用。比如我们只想比较若干特征的相对组合方向,而不想让整份记录的统一放大主导比较。可若长度代表误差幅度,归一化就会删除本来需要验收的信息。偏差(1,0)与(100,0)都归成(1,0),不能据归一化后的相同就说它们一样准确。
零向量需要单独处理。完全没有偏差当然是有意义的结果,但它没有方向,不能除以零来生成单位方向。程序可以把它单独标记、跳过方向比较或按明示规则处理;随手给分母加一个常数,只是选择了一种数值约定,不能让零向量突然拥有唯一方向。
内积大、夹角小、距离近,不是同一个排序
看一个不带物理单位的二维表示。查询q=(1,0),候选a=(10,0),候选b=(1,1)。q与a的内积为10,与b的内积为1;按内积最大选择,会选a。a与q完全同方向,b与q夹角为45度,按余弦最大也会选a。
但a到q的欧氏距离为9,b到q的距离为1,按原始距离最近则会选b。这里没有任何计算矛盾:a方向对得更齐,却远远长于q;b稍微偏了方向,整体位置反而更接近。
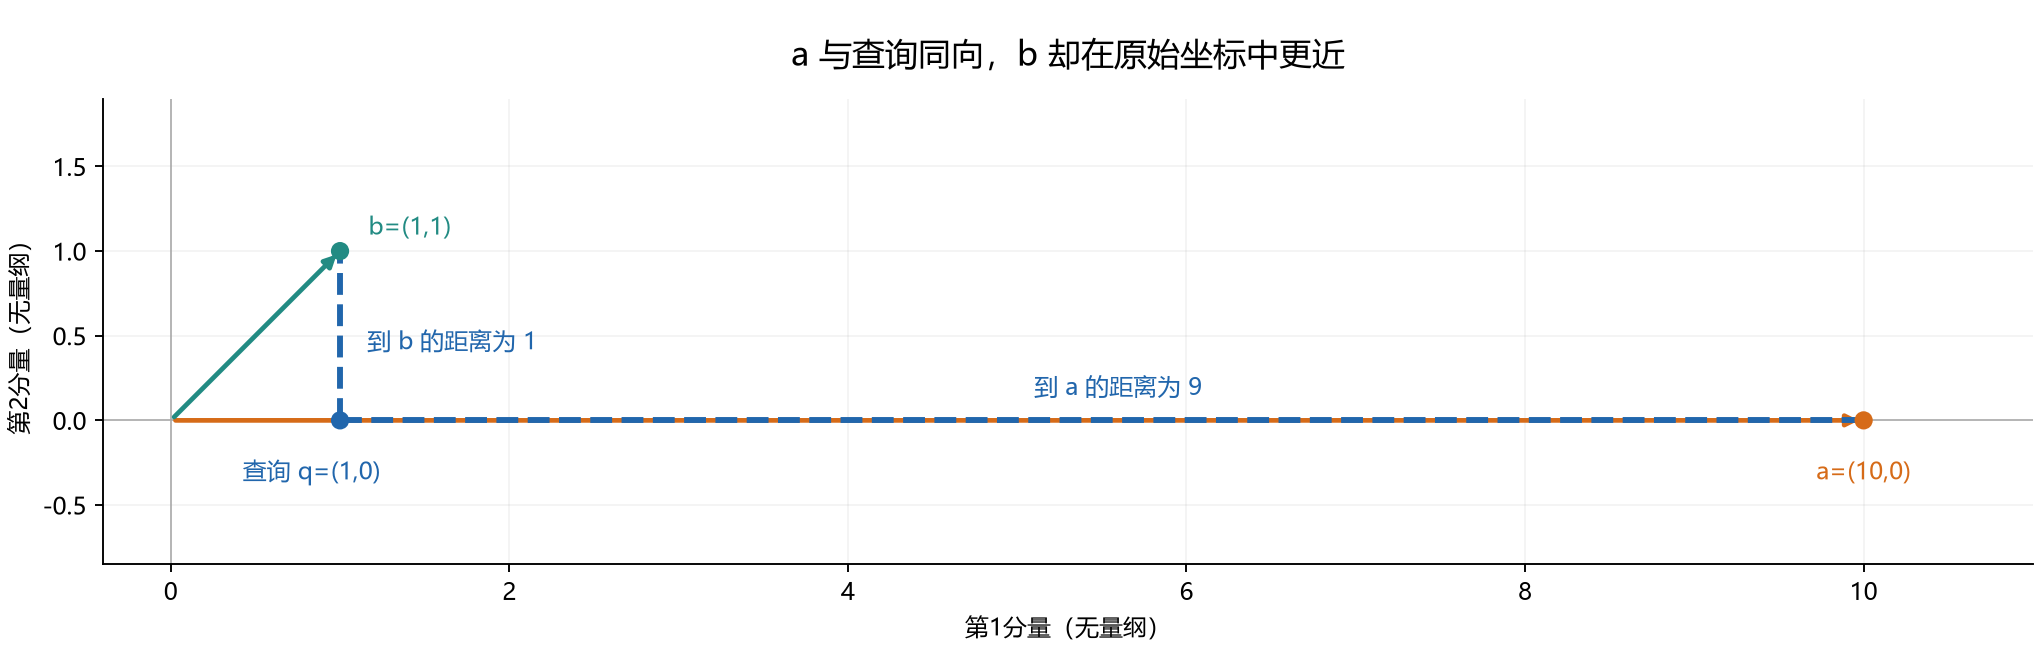
图三:查询q、候选a和b在同一坐标系中。虚线连接查询与候选,显示原始欧氏距离;横轴同向并不保证离查询更近。数值为教学表示,不是真实文本向量。
对任意两个向量,欧氏平方距离可以展开为‖u‖₂²+‖v‖₂²−2⟨u,v⟩。所以距离同时受到长度和内积影响。如果预先把两者都化成单位向量,长度项固定为1,关系便简化为:
在这个明确条件下,按单位向量的欧氏距离由近到远排序,与按余弦由大到小排序相同。我们知道了两种规则什么时候可以替换,而不只是背“相似度越大,距离越小”。未经单位化、各候选长度不相同时,刚才的a、b已经显示这种替换可能失败。
进一步用于语义检索时,还要检查模型怎样生成表示、什么样的距离适合它以及实际匹配效果。本讲先建立几何关系,A06再把它们用到向量匹配。一个夹角公式本身并不能证明两段文字表达同一意思。
十、把比较写成代码,先保证每个数对应正确对象
一行一个候选,沿字段计算范数
将甲、乙的误差分别放在两行,得到2×4的数组E。小叶希望每行输出四个数:绝对偏差总和、L2范数、最大绝对偏差,以及按四处分量计算的RMSE。代码可以这样写:
import numpy as np

target = np.array([0., 100., 200., 300.])
outputs = np.array([[3., 100., 200., 300.],
                    [1., 101., 201., 301.]])
E = outputs - target
l1 = np.linalg.norm(E, ord=1, axis=1)
l2 = np.linalg.norm(E, ord=2, axis=1)
worst = np.linalg.norm(E, ord=np.inf, axis=1)
rmse = np.sqrt(np.mean(E ** 2, axis=1))
print(l1, l2, worst, rmse)
# [3. 4.] [3. 2.] [3. 1.] [1.5 1. ]
这里axis=1指定沿每行的四处分量汇总,所以结果保留两个候选的位置。target是一维四分量数组,会对每行减去同一组目标;前提是列顺序确实对应同样四条定位线,不能靠广播的成功替代编号核对。
若只写np.linalg.norm(E),默认会把整张表的平方一起相加再开平方,得到√13,而非两个候选分别的L2。这个总量不是程序出错,而是调用表达了另一个对象。它把两套备选结果合成一个数,已经无法用来判断哪套更好。
若写np.linalg.norm(E, ord=1)而没有指定轴,对这个二维数组又会计算矩阵的最大绝对列和,本例得到4,仍不是两行各自的L1。函数名称相同,参数和输入维数改变了所取的范数。当前任务只需明确沿字段轴取向量范数,不必先学完矩阵算子范数。NumPy官方norm说明列出了这些区别。
成对内积与所有候选两两配对
若有两张形状相同的记录表U、V,一行对应一对向量,逐行内积可以写成np.sum(U * V, axis=1)。先逐元素相乘,再沿字段求和,正好落实定义。若改成U @ V.T,得到的则是U每一行与V每一行的所有两两内积。
两种运算都有用,但输出对象不同。前者给出原先对应的每一对,后者给出一张配对表。A04讲矩阵乘法时要求追踪输入与输出,在这里仍然适用:不能只看程序返回了一组分数,就假定这些分数对应我们想问的那组关系。
单位化时,也应逐行计算长度,并保留可广播的轴。下面另设三条记录,其中包括零向量,明确只给非零行定义方向:
V = np.array([[3., 4.], [0., 0.], [6., 8.]])
lengths = np.linalg.norm(V, axis=1, keepdims=True)
has_direction = lengths[:, 0] > 0
unit = np.full_like(V, np.nan)
unit[has_direction] = V[has_direction] / lengths[has_direction]
print(unit)
# [[0.6 0.8], [nan nan], [0.6 0.8]]
NaN在这里表示我们主动保留“此行没有定义单位方向”的状态,后续比较时应使用has_direction筛选。它不是说原来的零记录无效;对于误差验收,零误差恰恰是理想结果。方向分析和误差分析可以对同一行采用不同处理。
计算精度与验收尺度分别解决什么问题
数学上正交的两份向量,用浮点运算计算内积,结果可能是一个很小的非零数。可以根据量级设置数值容差,避免把舍入残差当作实质差异。可是验收中的2毫米是任务允许的偏差,两者不是同一种“容差”。
同样,计算夹角时若因舍入让余弦略超出[−1,1],把它裁回定义域可以防止反余弦报错,但应先保证公式和非零条件正确。不能拿裁切掩盖本来算出1.8的错误,更不能把这种数值处理当成结果准确的证据。对超大数或极小数,还需选择合适的数据类型和稳定实现,不能仅凭短示例在小整数上通过就外推所有数值范围。
十一、现在可以完成这次定位检查
回到已经确定的任务,小叶先检查四处最大绝对偏差。甲为3毫米,超过2毫米,不合格;乙为1毫米,合格。因此原始两个候选中,应保留乙。这个决定首先来自明确的逐处要求,并不需要让一个综合分数替代验收条件。
若加入第三节已经算过的甲修正版,其误差为(2,1,0,0),最大偏差恰好2毫米,也合格。接着按事先约定的L2比较:甲修正版为√5毫米,乙为2毫米,仍选择乙。这一次不是因为“甲总是不行”,而是在同样允许条件下,乙的平方偏差总量更小。
小叶可以让程序把这两步明确分开:
candidate_errors = np.vstack([E, [2., 1., 0., 0.]])
names = np.array(["甲", "乙", "甲修正版"])
eligible = np.max(np.abs(candidate_errors), axis=1) <= 2.
scores = np.linalg.norm(candidate_errors, axis=1)
allowed = np.flatnonzero(eligible)
if allowed.size == 0:
    print("没有候选满足位置要求")
else:
    chosen = allowed[np.argmin(scores[allowed])]
    print(names[chosen])  # 乙
得到乙以后,保留它的四处误差及原坐标,交给下一阶段检查,而不是只留下一个“2毫米”的L2分数。原记录能说明偏差都向右,后续还可以研究是否应做共同位置修正;但本轮比较的三份候选已经固定,不能把尚未生成和核验的新结果当作已完成改进。
通过这次检查,我们把几种问题分开又接了起来:误差向量记录每处发生了什么;内积解释调整与已有偏差怎样共同作用;不同范数概括不同方面的大小;距离比较输出与目标;尺度和单位决定比较是否公平;代码中的轴保证每个分数对应正确候选。
以后读到AI系统中的“向量接近”“误差下降”或“归一化以后相似”,就可以进一步追问它具体保留了哪些差别。回答这些问题不要求先掌握整个模型,但会让我们更准确地理解它正在优化和比较的对象。
十二、练习与参考分析
练习一:三种大小规则为什么选得不同
另有三处分量的误差,甲为(2,−2,0)毫米,乙为(3,0,0)毫米。分别用L1、L2、L∞比较。若每处偏差都必须不超过2.5毫米,哪份结果可以进入后续选择?直接相加误差会造成什么误判?
参考分析: 甲的三个范数分别为4、√8、2,乙分别为3、3、3。L1倾向乙,L2与L∞倾向甲。甲把误差分布在两处,乙集中在一处,三种规则对这种分布的处理不同。逐处2.5毫米要求保留甲、排除乙,不能由乙的L1较小推翻这个条件。
甲的有符号总和为零,但两处仍各偏2毫米。求和保留的是左右抵消后的总偏移,不能解释为全部位置准确。若要观察平均偏向,可以使用它;若要判每处合格,则必须保留绝对偏差的相应规则。
练习二:负内积为何还不保证改善
已有二维误差e=(2,1),候选调整c₁=(−1,0)、c₂=(0,−1),调整量大小相同,哪种更能减小L2误差?再考虑c₃=(−5,0),它与e的内积为负,结果是否仍改善?
参考分析: 原平方范数为5。前两种调整的平方范数都是1,但与e的内积分别为−2、−1,所以新平方范数为5−4+1=2与5−2+1=4。第一种调整更有效,因为它作用于当前偏差更大的分量。
c₃与e的内积为−10,但自身平方范数为25,调整后平方范数为5−20+25=10,反而增大。改善需要整体满足2⟨e,c⟩+‖c‖₂²<0,负内积只涉及其中一项。也可以直接观察新误差(−3,1),看见向左修正已经过头。
练习三:允许每处达标,是否等于综合范数达标
两处分量的允许偏差分别为2毫米与1毫米,实际误差为(2,1)毫米。每处都合格吗?按允许尺度缩放后的L∞与L2各是多少?若统一把毫米改成厘米,需要怎样改尺度?
参考分析: 两处都恰好达到上限,因此逐处合格。除以各自尺度后是(1,1),L∞为1,L2为√2。若要求缩放后的L2≤1,就会判不合格,因为它给两处偏差共同设置了更紧的整体范围。这并非代码矛盾,而是验收条件变了。
改成厘米后,误差为(0.2,0.1),尺度也变成(0.2,0.1),比值保持(1,1)。只改误差数值却沿用以毫米表示的尺度,会改变比较含义。这里没有靠增加小数位解决问题,而是保持单位配对。
练习四:新坐标的L2是否总是物理长度
仍用b₁=(1,0)、b₂=(1,1)组成新基。某位移的新坐标为a=(1,1),实际位移是什么?直接取a的L2与实际长度有何差别?用G=BᵀB核对结果。
参考分析: 实际位移为b₁+b₂=(2,1),长度√5;新坐标自己的标准L2为√2,它衡量的是两项系数,并未计入基的长度与夹角。G=[[1,1],[1,2]],aᵀGa=5,开平方恢复实际长度。
换基只是换了一种记录方式,原位移没有因此伸长。若我们坚持在新系数上使用标准点积,也能定义一种数学几何,但那已经不是题目要求保留的原物理几何。区别在比较规则,不能把两种长度直接混用。
练习五:同方向是否等于同样准确
误差u=(1,0)、v=(4,0)。它们的余弦、原始欧氏距离、各自L2和单位化后的距离分别是什么?若每处误差不超过2,能否先单位化再验收?
参考分析: 两者余弦为1,原始距离为3,各自L2为1与4;单位化后都成为(1,0),彼此距离为零。它们具有相同方向,却有不同的误差幅度。
原验收应保留u、排除v。先单位化会把幅度抹掉,导致两份记录看起来一样,无法再执行原来的2单位限制。若目标只是比较偏差模式,单位化可以有用,但应另存原范数;零误差还必须单独处理,不能除以零。
练习六:矩阵整体的数,能不能代表每个候选
误差表E=[[3,0],[0,4]],一行一个候选。np.linalg.norm(E)、沿axis=1取L2、沿axis=0取L2分别回答什么?若程序报告整体范数为5,能否据此说两个候选各自误差都为5?
参考分析: 默认把全部四个数平方相加再开平方,得到5;沿axis=1得到[3,4],分别概括两个候选;沿axis=0也得到[3,4],但分别概括第1与第2个字段在两候选中的数值。后一结果在本例与逐行结果恰巧相同,含义仍不同。
可换成E=[[3,1],[0,4]]检查:逐行为[√10,4],逐列为[3,√17],就能看见轴选择的差别。两个候选是备选方案,把两份候选的偏差共同汇总成一个数,并不等于分别评价了它们,更不能把这个总量复制到每一行。先明确一份结果在数组中占哪一行、每一列代表什么,再选择汇总轴,才对应真正的比较问题。