小叶准备给社团活动做一组海报。他已经画好一个简单的三角形装饰,现在希望让AI写一小段程序,把这个图形拉宽、转向,再放到版面的指定位置。对单个图形,拖动鼠标也能完成;当同样的操作要用于许多图形时,把变换写成可重复的规则就更方便。
AI交来的代码里出现了几个矩阵,以及连续的乘号。小叶真正需要判断的不是“这里有没有使用线性代数”,而是:这些数字究竟对图形做了什么?先乘哪个矩阵才符合要求?为什么代码的形状完全正确,图形仍可能变错?
本章从这次图形处理出发,理解线性变换与矩阵乘法之间的关系。矩阵不只是存数字的方格,它还可以记录一个输入怎样变成输出。把两个这样的规则接起来,才会看见矩阵乘法为什么采用现在的计算方式,以及它为什么不能像普通数的乘法那样随意交换位置。
一、先明确对象发生了什么变化
把一句操作要求落到固定的画布上
我们使用一张教学画布:横轴向右,纵轴向上,坐标数值统一以厘米记录。原点与两条轴始终固定。以下尺寸和形状均为教学设定,不对应某个真实设计软件的默认配置。
三角形的三个顶点依次是(1,1)、(3,1)、(1,2)。小叶希望对每个顶点进行同样的三步处理:先把横向坐标放大为原来的两倍,纵向保持;再绕画布原点逆时针转90度;最后向右移动5厘米、向上移动1厘米。三个顶点处理完后,仍按原来的顺序连接。
这里的“横向”指固定画布的横轴,“绕原点”也已经指定。图形转过以后,它自身的长边可能换了方向,但画布的横、纵方向没有跟着转。如果需求换成“始终沿图形自己的长边拉伸”,那是另一种操作约定,不能悄悄套用同一句横向拉伸。
先追踪顶点(3,1)。横向放大后,它到达(6,1);再逆时针转90度,来到(−1,6);加上最后的固定移动,得到(4,7)。这一条清楚的变化过程,可以用来核对AI的矩阵实现。程序若交出别的结果,就要检查它是否改变了操作顺序或参考方向。
本章改变对象,前章更多是在改变记录
A03中,同一建筑可以用不同的基记录坐标。建筑没有移动,变化的是我们用哪些参考位移来描述它。本章的图形处理则保持同一套画布坐标,让图形上的点实际移到新位置,边的方向和长度也可能改变。
两种情形都能出现矩阵乘法,因而仅看一个算式,不能断定它是在“换坐标”还是在“变对象”。需要知道输入与输出分别代表什么。数学语言相同,不等于任务含义相同。
本章先把点相对于原点的位置写成列向量,只讨论几何坐标的连续变换。若最后要把一张像素图片旋转并重新生成像素,还涉及在哪些位置取样、空白怎样填充等问题。这里处理的是三角形顶点与连线;坐标算对后,仍需由绘图程序把它们画出来。
二、线性:保持“先合成”和“后合成”的一致
横向拉伸为什么可以分别处理各部分
把横向放大两倍的规则记为S。它把位置(x,y)变成(2x,y)。为了理解这个规则的特征,暂时把输入看成相对于原点的位移:一段位移可以由若干部分相加得到。
例如,向右3厘米、向上1厘米的位移,可以拆成向右3厘米和向上1厘米。拉伸以后,向右的部分成为6厘米,向上的部分仍是1厘米,两部分合起来就是(6,1)。先合成整个位移再拉伸,与先拉伸两部分再合成,结果相同。
而且,同一个位移若整体放大三倍,再进行横向拉伸,与先拉伸、再把结果放大三倍,也会得到相同结果。这种一致并不只对整数倍成立;半份位移、反方向位移也遵循同一规则。
线性变换要求同时保持向量相加与实数倍乘。把一般的变换记作T,其条件可以写成:
这里u、v是允许输入的向量,a是任意实数。第一条说,各部分对结果的贡献可以分别计算后相加;第二条说,把一份输入按比例改变,对应贡献也按相同比例改变。它们要求对整个约定的输入空间成立,不是只挑两次试验碰巧相等。
在固定的线性规则下,可以把这两条合在一起使用:输入由多少份u和多少份v组成,输出就由相应份数的T(u)与T(v)组成。这个性质常被称为叠加性。它让我们不必为每一个新输入重新设计处理办法。TU Delft的线性变换教材以保持相加和倍乘给出定义。
保持关系,不等于所有外形都不变
横向拉伸会改变某些长度和角度,却仍然是线性的。因此,“线性”不能理解为“不变形”,也不能理解为“只会把物体沿直线移动”。它描述的是输入组合与输出组合之间的关系。
例如,两点之间的中点可以写成两个位置向量各取一半后相加。在线性变换之后,这个中点仍是两个变换后位置的中点。线段上的位置也会按原有比例映到两端的连线上;如果两端被映到同一点,整条线段还可能缩成一个点。
所以,线性变换可以转向、拉伸、倾斜,也可以压扁。它保留了组合关系,却未必保留原来的距离、角度或可区分的细节。后面判断变换能否撤销时,这个区别会直接起作用。
原点不动是一项快速检查,却不是完整证明
把倍数取为零,就能看出线性变换必须把零向量送到零向量。几何上,原点必须保持在原点。若一种操作无论输入是什么,都额外加上同一个非零位移,它就不满足本节的线性定义。
但“原点不动”只是一项必要条件。例如,规则F(x,y)=(x²,y)也把原点送到原点,却不是线性变换。把(1,0)放大两倍以后再处理,会得到(4,0);先处理(1,0)再放大两倍,只得到(2,0)。它对横向贡献的放大取决于输入本身,已经破坏固定比例。
小叶因此可以用零输入快速排查固定偏移,再用输入组合检查规则;不能只看输出图形似乎规整,就认定它是线性的。反例可以否定一个宣称,而有限几次通过只能支持那些样本,不能独自证明全部实数输入上的性质。
三、为什么看几个基向量,就能知道整个变换
矩阵的列记录最基本输入的去向
在这张平面画布上,标准基向量是e₁=(1,0)与e₂=(0,1)。它们分别表示向右1厘米和向上1厘米。任何位置(x,y)都能按这两种基本位移合成。
对一个已经确认的线性变换T,只要知道T(e₁)与T(e₂),就知道原来的每一份横向贡献、每一份纵向贡献分别被送往哪里。线性性质保证它们仍可按原有的倍数组合:
因此,可以把T(e₁)放在第一列、T(e₂)放在第二列,组成矩阵A。矩阵乘上输入列向量,就是按输入的两个系数合成这两列。这里的列顺序有确定含义,不能只看几个数字是否都出现了。
对横向放大两倍的S,向右1厘米变成向右2厘米,向上1厘米保持原样,所以:
我们沿用S同时表示这项线性变换和它在当前标准基下的矩阵;后文R、H也采用同样约定。输入输出坐标都以同一种厘米数表示,矩阵里的2是比例,0表示该输入方向没有给那一项输出增加贡献。
用基向量检查,能发现“矩阵看着差不多”的错误
假设另一项规则要求:向右1厘米的基本位移变成(2,1),向上1厘米的基本位移变成(−1,3)。对应矩阵就应是[[2,−1],[1,3]]。
这个矩阵把(3,1)变成3(2,1)+(−1,3)=(5,6)。若AI把两支输出向量误排成行,写成[[2,1],[−1,3]],程序仍能乘上两分量输入,但同一位置会被送到(7,0)。矩阵形状没有暴露错误,基本方向的去向却已经变了。
最直接的核对是分别输入(1,0)与(0,1),看结果是否与约定一致。前者会选出第一列,后者会选出第二列。在已知两个实现都遵守线性规则的前提下,它们若对一组基的作用相同,就对全部输入相同,因为所有输入都能由这组基合成。
这个结论的条件值得看清。一个任意黑箱也可能在两个基本输入上模仿目标,却对它们的组合做别的处理。基向量测试之所以能够确定全部行为,是因为线性已经得到保证。对包含裁切、取最大值或条件分支的代码,仍要另查那些步骤。
从输入方向看列,从输出指标看行
列与行给我们两种互补的读法。对按要求构造的矩阵,第一列说明一份横向输入怎样影响两个输出;第一行则说明输出的横向坐标怎样由输入共同确定:两份横向输入减去一份纵向输入。
推广到A是m行、n列的矩阵时,它接收n个输入分量,产生m个输出分量。第j列记录第j种基本输入的整体去向;第i行规定第i项输出要汇总哪些输入贡献。这个对应不要求输入与输出分量数相同。
若输入分量代表不同单位,矩阵系数还要承担相应的单位转换。例如,某一行把小时数转换为分钟数时,系数便带有分钟与小时的对应。矩阵形状只告诉我们数的数量,不能代替字段名称、单位和顺序的说明。
四、用几何动作读懂几类矩阵
旋转:两种基本方向一起转
逆时针旋转90度时,向右的基本位移变成向上,向上的基本位移变成向左。按列放好这两个结果,得到:
这就解释了(6,1)为什么变成(−1,6):原来的纵向贡献转成向左,原来的横向贡献转成向上。负号不是一个需要单独记忆的装饰,它记录了旋转后向左的方向。
任意角度的旋转也可以用同样方法构造。向右1单位转过角度θ后,分量为(cosθ,sinθ);向上1单位转过同样角度后,分量为(−sinθ,cosθ)。把它们作列就得到常见旋转矩阵。若需要具体角度的计算,再按程序要求统一角度或弧度单位。TU Delft的几何变换章节给出了这种构造。
剪切:越高的位置,横向移动越多
再看矩阵H=[[1,1],[0,1]]。它把(x,y)变成(x+y,y):高度保持,横向额外加上原来的高度。原点不动,横轴上的点也不动;位于同一高度的一排点会获得相同的横向移动。
这叫作一种剪切变换。它把单位正方形变成平行四边形,形状倾斜了,但每一份纵向输入给横向输出增加的贡献始终相同,因此仍保持相加与倍乘。图形上方移得较多,不等于程序在任意弯曲地扭动不同区域。
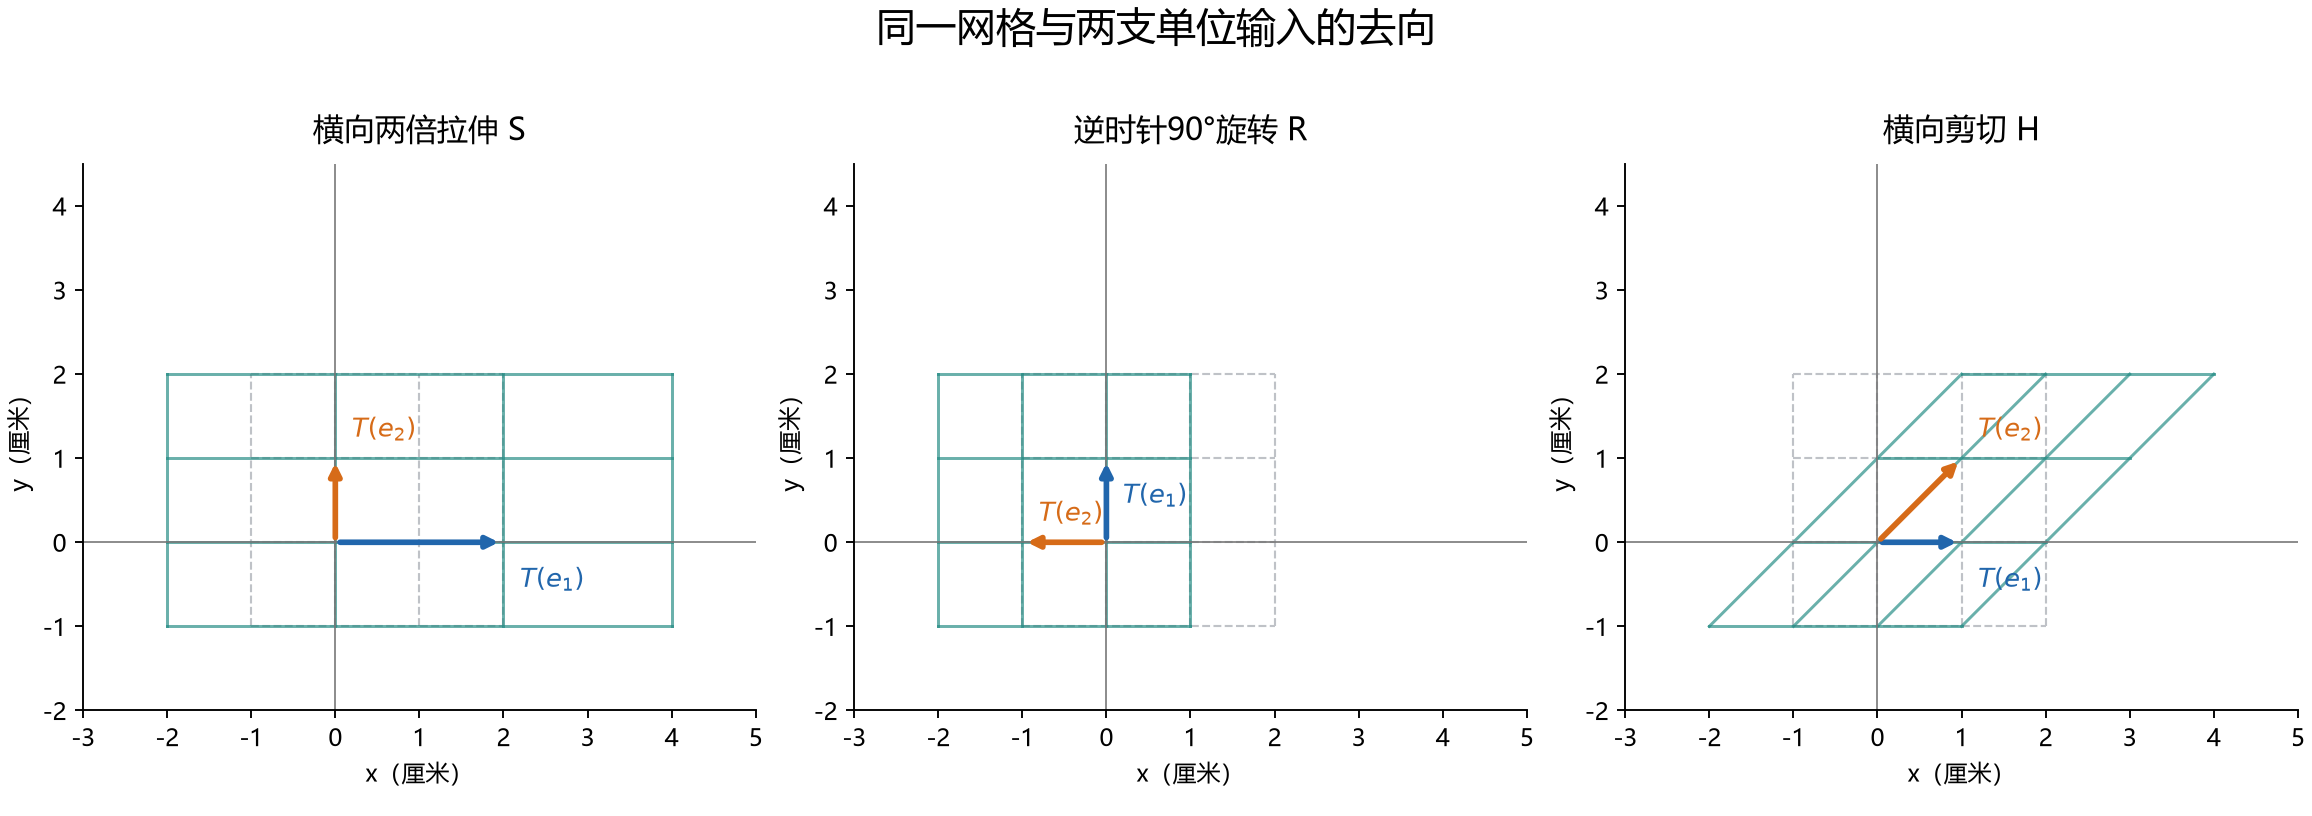
图一:三幅图均使用固定画布坐标。浅色虚线是原网格,实线是变换后的网格;两支彩色箭头显示原来向右、向上的单位输入分别去了哪里。
图像帮助我们观察变换,但矩阵含义不靠视觉猜测。看见一幅倾斜图形时,我们可以追问:同一排点是否按同一规则变化,基本输入的输出是否能合成其他点。这样才能把外形与线性关系接起来。
反射与压平:负数和零分别做了什么
矩阵[[−1,0],[0,1]]把(x,y)变成(−x,y),相当于以纵轴为镜面对折。横向贡献反向,纵向贡献保持。负系数在这里表示方向翻转,并不代表“无效数据”。
矩阵D=[[1,0],[0,0]]则把(x,y)变成(x,0)。所有高度被压到横轴上。它同样是线性的,但(2,1)、(2,5)都会得到(2,0),原来的两个位置已经无法区分。
这说明线性变换不一定可逆。旋转、非零比例拉伸可以找到撤销办法,压平却已经把某些差别合并。后面讨论秩与投影时会更系统地描述这种信息变化;在当前任务中,一个具体的碰撞例子已足以提醒小叶:不能认为任何矩阵操作都能靠“再乘一个矩阵”完整还原。
五、两个矩阵相乘,表示前后两步接起来
为什么“先拉伸,再旋转”写成RS
现在把小叶的前两步连起来。位置向量先经过S,再经过R,处理过程写作R(Sx)。矩阵乘法把这个复合规则记为RS,使得:
在列向量写法里,最靠近输入的S先起作用。读这个式子时,可以从输入出发,先看到S的输出,再把它交给R。与其背“乘法顺序反过来”,不如沿着数据实际经过的步骤读它。
乘积RS的第一列可以这样得到:原来的向右1单位先被拉成向右2单位,再转成向上2单位,所以是(0,2)。第二列来自原来的向上1单位,它不受横向拉伸影响,随后转成向左1单位,所以是(−1,0)。这两列已经完整描述复合线性变换。
因此,矩阵乘法不是把对应位置简单相乘。它要求追踪前一个变换产生的整份中间输出,再看后一个变换怎样处理这份输出。只有这样,乘积矩阵才能对所有输入复制两步操作的结果。
顺序改变,任务也随之改变
若先转向,再按画布横向拉伸,规则就变成SR,矩阵为[[0,−2],[1,0]]。原来向右的方向先转到上方,不再被横向拉伸;原来向上的方向先转到左方,反而被拉长两倍。
对顶点(3,1),先伸后转得到(−1,6),先转后伸得到(−2,3)。两者都由同样两个矩阵构成,也都可以合法相乘,却完成了不同的动作。
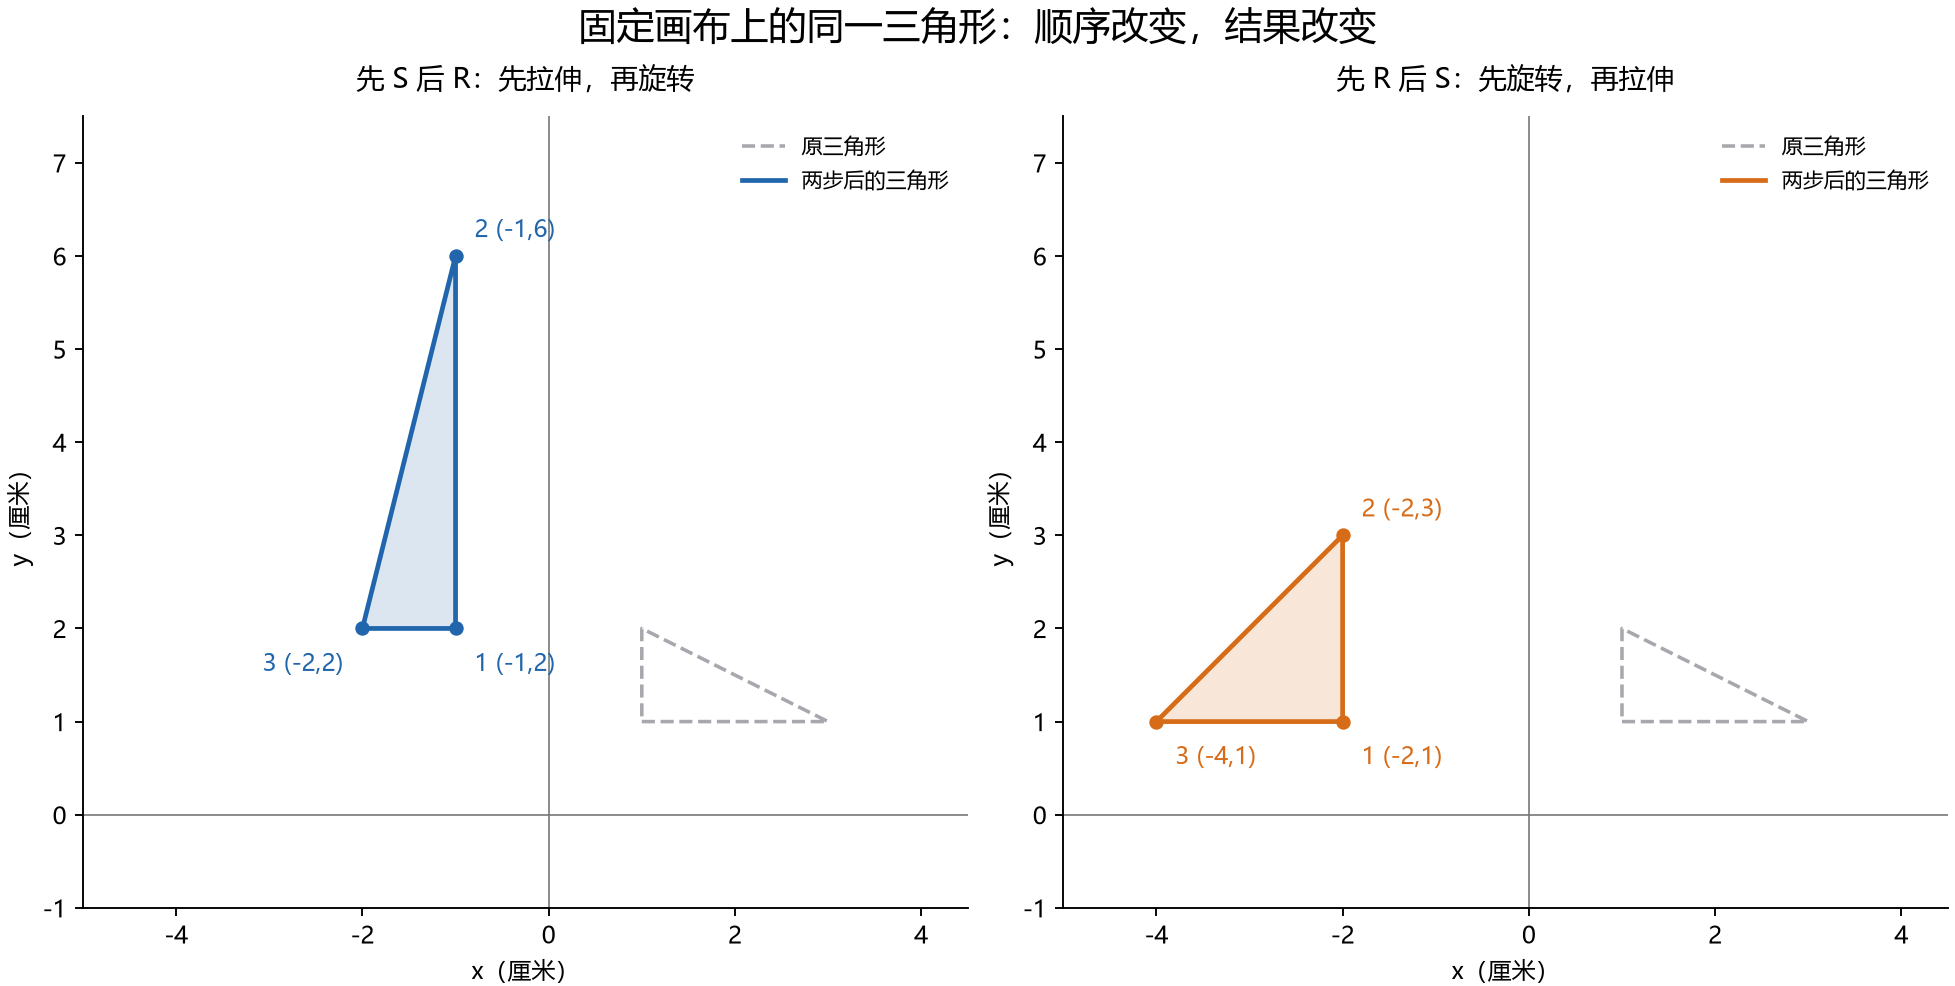
图二:此处只比较前两步,尚未加最后的平移。左图先横向拉伸再逆时针转向,右图先转向再沿固定画布横向拉伸;对应顶点的编号保持不变。
我们据此说,矩阵乘法一般不满足交换律。这里“一般”不是说永远不能交换:例如整体等比例放大与绕原点旋转可以交换,因为所有方向同时按相同比例放大。能否交换取决于具体操作,不能仅从矩阵尺寸相同得出答案。
一次输出相同,也未必说明两项规则相同
如果小叶只用原点测试,RS与SR都会输出原点,这个测试无法分辨顺序。对一般的两种线性规则,某个非零输入上的结果也可能相同,而其他方向的结果不同。测试数据需要能触及需求中真正重要的方向。
对于当前两个已知的线性实现,用一组基测试可以完整比较;画出三个非共线顶点,又能让最终三角形的形状差异直观可见。不同检查各有作用,不能把一次“结果看起来差不多”当作所有输入行为相同。
六、乘法里的求和,是把经过中间分量的贡献合起来
不同长度的表示也能前后衔接
图形例子使用两个二维矩阵,但许多AI程序会把一份表示先变成长一些的向量,再变成另一种长度。为了看清乘法规则,我们另设一个小型数值处理例子,暂不涉及训练。
小叶从图中取两个位置的亮度读数,用x₁、x₂记录。以下系数都是人为设定,目的只是演示处理过程;这些混合数值不代表海报质量,也不宣称是真实模型学出的特征。
第一步生成三项中间记录:第一项是x₁+2x₂,第二项是2x₁,第三项保留x₂。第二步再把第一项加上两份第三项,作为第一个输出;用第二项减去第三项,作为第二个输出。两个矩阵是:
A有3行2列,接收两个数、产生三个数;B有2行3列,正好接收这三项中间记录,再产生两个数。输入为(4,2)时,中间结果是(8,8,2),最终得到(12,6)。
但这三项中间记录不仅要数量正确,还必须按既定顺序交接。B的第一行中,第三个位置的系数2专门对应“保留的第二处亮度”。若把中间记录重新排序却不改B,相同形状仍可能得到不同结果。
一个乘积元素怎样概括多条贡献路径
现在只追踪原始第二处亮度对最终第一个输出的作用。它先以两倍进入中间第一项,再以一倍进入中间第三项。后一步取一份中间第一项、两份中间第三项,于是这两条路径给最终输出的贡献合起来相当于四份原始第二处亮度。
原始第一处亮度则通过中间第一项贡献一份;它虽然也进入中间第二项,但后一步的第一个输出不取那一项,因此那条路径在这个输出中没有贡献。合起来,第一个最终输出就是x₁+4x₂。
同理,第二个最终输出为2x₁−x₂。整个复合矩阵因此是:
这种沿中间记录追踪的方法,就是“行乘列再求和”的含义。若A把n个输入变成m个中间分量,B把m个中间分量变成p个输出,那么乘积C的第i行、第j列记录第j项原输入对第i项最终输出的总贡献:
k依次指向各个中间分量。每一项先算一条路径的两段作用,再把所有路径的作用相加。这个求和把各条中间路径的贡献合成最终系数,因此不能只从同一位置拿两个数相乘。矩阵乘法的列定义与行列展开给出了同一规则的正式写法。
中间尺寸相等,是规则能连接的要求
一般形状关系可以写作:
两个m相同,是因为A交出的每一项中间记录,都要在B的输入位置上找到对应。最后留下p个输出、n种原输入,乘积就有p行n列。
这个规则并不是要求两个矩阵形状一样。反过来的AB在本例中也能计算,但它会成为3×3矩阵:接收一份三分量输入,先用B变成两项,再用A变回三项。它的输入对象已经与原来的两亮度读数不同,不是同一条流程换了一个书写顺序。
把输入、输出和中间字段写明之后,维度错误往往更容易理解。遇到报错时,先检查前一步输出与后一步输入的形状及字段的对应关系,再判断怎样调整数组。若字段本来不匹配,强行重塑数组使乘法能运行,并没有解决任务问题。
七、可以改变结合方式,不能擅自改变步骤
结合律让固定规则能够预先合并
假设数据依次经过A、B、C三个线性变换,整个结果为C(B(Ax))。可以先把B与A合成一个矩阵,也可以先把C与B合成一个矩阵,最终数学关系相同:
这就是矩阵乘法的结合律。两种写法都保持先A、再B、再C,只是决定先计算哪一个中间乘积。它与交换律不同;将CBA改成ABC,通常已经把步骤改了。
对小叶的许多三角形,如果S和R始终固定,可以先求RS,再把这个乘积用于每个顶点。这样不必让每个顶点都重复走两次矩阵乘法。若后来改变旋转角度,则应重新生成对应的复合矩阵,不能继续沿用旧的合并结果。
数学上的完全相等,也不要求所有浮点实现逐位相同。计算机表示的小数有精度限制,不同运算顺序可能带来微小舍入差异。因此,程序核对通常结合合理的数值误差范围,不能只凭最后一位不同就断言线性关系不成立。
中间结果的大小,可以比最终结果差很多
再设三个固定矩阵U、V、W,形状分别为1000×2、2×1000、1000×2。现在只比较怎样计算同一个乘积UVW,不改变任何矩阵位置。
若先算UV,中间结果是1000×1000,包含一百万个数,再与W相乘。若先算VW,中间结果只有2×2,最后再乘U。两条路线的最终结果都是1000×2,数学上相同,中间存储却相差很大。
按朴素矩阵乘法统计标量乘法次数,第一条路线两步各需约二百万次,共四百万次;第二条路线两步各需四千次,共八千次。这些数字只是该计算方法下的工作量比较,没有计入加法、内存搬运或具体硬件优化,不能直接当成实际耗时比例。
这个例子让结合律有了工程意义:在保持数学操作顺序的同时,可以选择更合适的中间计算。真正决定效率的还包括矩阵结构、数据类型、设备及批量大小;但先避免无必要的巨大中间矩阵,已经是看懂程序时可作出的具体判断。
八、把一个向量的规则应用到一批记录
一行一个顶点时,为什么要出现转置
小叶的文件通常是一行一个顶点。把三个顶点放在矩阵X里,就是:
前面用的是列向量规则y=A x。一行记录则是x的转置。将这个关系转置,得到yᵀ=xᵀAᵀ,所以一行一个样本的整批处理应该写为Y=X Aᵀ。
转置在这里不是为了碰巧把尺寸凑成可乘。它让每行仍按同一个列向量规则处理,输入的第一个分量继续对应A的第一列。若A是不对称矩阵,漏掉转置即使不报错,也可能改变变换方向。
对于先S再R,行批量写法为X Sᵀ Rᵀ;若先合并矩阵,则写为X(RS)ᵀ。这两个式子相同,因为整个乘积转置会反转因子的排列。行写法从左到右追踪样本,列写法从最右边的输入往左追踪,二者没有改变实际步骤。
下面用NumPy实际计算。代码中的@表示矩阵乘法,.T表示转置:
import numpy as np

X = np.array([[1., 1.], [3., 1.], [1., 2.]])
S = np.array([[2., 0.], [0., 1.]])
R = np.array([[0., -1.], [1., 0.]])
combined = R @ S
stepwise = X @ S.T @ R.T
merged = X @ combined.T
print(merged)  # [[-1.  2.], [-1.  6.], [-2.  2.]]
print(np.allclose(stepwise, merged))  # True
输出仍是一行一个顶点,行与原来的顶点编号相配。若误写为X乘combined而不转置,结果会变成[[2,−1],[2,−3],[4,−1]],不是要求的变换。这里恰好都是两列,尺寸检查无法替代基向量与具体顶点检查。
星号也能算出数字,却不是同一件事
对于NumPy数组,*执行逐元素乘法,@执行矩阵乘法。拿S与R来说,逐元素相乘会得到全零矩阵:S非零的位置,R恰好为零;R非零的位置,S又为零。这与先拉伸再旋转完全不同。
因此,代码能返回一个2×2数组并不说明它正确实现了复合变换。查看运算符、列含义和一个有代表性的输入,比只检查输出类型更接近任务本身。NumPy的matmul文档说明了二维矩阵乘法及@的对应关系。
同一种矩阵乘法,左右两边可能处理不同的轴
对N行、n列的记录表X,右乘一个n×m矩阵,会在每行内部重新组合特征,得到N行、m列。样本数保持,记录的内容改变。本章的图形变换属于这一种情况。
若左乘一个K×N矩阵P,则得到K行、n列,处理的是不同样本之间的组合。例如,把三行顶点各取三分之一相加,会得到它们的平均位置。此时并不是把每个顶点都施加同一变换,而是把三条记录汇总成一条。
程序里“乘一个权重矩阵”因此还不够具体。要看被组合的是样本轴还是特征轴,汇总后是否仍能保留原来的对象编号。A02关于轴的认识,在这里与线性变换的输入输出含义接上了。
九、平移、绕点旋转与撤销:把完整操作写清
固定平移为什么要单独保留
小叶的第三步是给所有顶点加同一个位移h=(5,1)。前两步由A₀=RS记录,完整操作为:
这是一个仿射变换:线性部分之外还有固定偏移。它把原点送到h,因此只要h非零,就不满足原平面上的线性定义。软件中常把这类操作放在同一个变换模块里,但合并处理时仍须保留固定偏移,才能得到要求的位置。
如果有两段仿射处理,第一段为A x+a,第二段为B y+b,那么接起来得到:
第一段已经加上的偏移,会和中间对象一起经过第二段变换。最终偏移因此是B a+b,而不是只把两个偏移直接相加。这个区别在图形处理中很容易看见:先向右移动,再转90度,原来向右的那次移动也会转成向上。
绕指定中心旋转,不等于绕原点旋转
如果小叶把需求改为绕c=(2,1)旋转90度,应先把这个中心移到原点,让每个点用相对于c的位移表示;旋转后再把中心加回去。公式为R(x−c)+c。
对点(3,1),它原来位于中心右方1厘米,旋转后应位于中心上方1厘米,得到(2,2)。若直接用R乘(3,1),却会得到(−1,3),因为那是在绕画布原点转。
把绕点操作展开为R x+(c−R c),可以看出它仍是仿射变换。本例的固定偏移为(3,−1)。这项偏移不是装饰性的修补,而是保证指定中心不动:将x=c代入,输出仍为c。
这个检查也能帮助澄清AI收到的自然语言。“旋转90度”还没有确定旋转中心;先给出中心,才能把希望保持不动的位置转成可验证条件。若所用软件采用纵轴向下的像素坐标,还应按它的约定重新解释旋转方向,不能直接照搬当前向上为正的矩阵。
增加一个常数位置,可以把平移放进矩阵
有时程序希望把拉伸、旋转和平移都统一写成矩阵乘法。做法是在二维位置后面增加一个固定的1:
乘完以后得到(5−y,2x+1,1)。前两项正是小叶完整操作的结果,最后一项仍保持1。最后一列与这个固定1相乘,便把平移量加入前两项。这是齐次坐标在当前仿射情形中的用法。
增加的1不是又测量出一种空间方向。我们只是在三分量表示中选定最后一项为1的一层,借更大的矩阵保存固定偏移。二维原点用(0,0,1)表示,也不是三维零向量;所以这里能用矩阵,并未推翻“平移在原二维空间中不是线性变换”。
本章只处理最后一项保持1的这些矩阵,不涉及一般透视投影。若一个程序改变最后一项后还要进行除法,整体输入输出关系需要再按实际操作判断,不能把齐次形式中的一次矩阵乘法当作全部处理都是原变量的线性关系。
撤销时,要先撤最后做的动作
完成主流程后,若给出一个变换后的点q,恢复原位置应先减去h,撤销最后的平移;再顺时针转90度,撤销R;最后把横向缩回一半,撤销S:
对q=(4,7),先得到(−1,6),再转回(6,1),最后恢复(3,1)。逆矩阵表示撤销一整项变换,不是把矩阵每个元素分别取倒数。R中有零元素,却仍可以完整撤销;压平矩阵D则因已经合并不同位置而无法完整撤销。
撤销顺序与原流程相反。若只写出两个逆矩阵,却仍按原来的操作次序使用,一般不能回到原对象。这个道理也适用于多段数据变换:先确认每一步是否可逆,再按依赖关系逐步恢复。
十、AI里的线性层为什么还需要其他操作
固定权重把输入重新组合成输出
许多模型中的线性层,可以理解为把输入的若干分量按权重混合成新的分量。矩阵系数由训练确定还是人工写入,不改变固定权重下矩阵乘法的数学性质;区别在于这些系数怎样得到,以及它们对任务是否有用。
例如,输入有两项、输出有三项时,按列向量习惯可写成y=W x+b,其中W是3×2矩阵,b是三分量偏置。每个输出都有一组组合输入的系数,还可加一个与当前输入无关的常数。输出分量更多,首先说明生成了更多位置,不自动证明增加了新的独立信息或取得了更好的效果。
PyTorch的Linear文档采用行样本写法,计算形式为x Wᵀ+b,权重形状为输出特征数×输入特征数,并允许使用偏置。这里出现转置,与前面一行一个顶点的写法一致。名称中的Linear并不要求默认偏置为零;查看具体公式,就能把术语与实际运算对应起来。
我们当前只读懂这种模块的作用,不需要先训练一个模型才能检验形状和处理顺序。真正使用时,输入字段、预处理、权重版本与后续步骤仍共同决定结果的意义;一张权重矩阵自身不会告诉我们某个输出一定代表“美观程度”。
连续很多层,什么时候仍能合成一层
若几个固定矩阵之间只有线性变换,它们的组合仍是一次线性变换。若每层另外加固定偏置,整体仍可按上一节的公式合成为一次仿射变换。增加层数本身,没有让这条输入输出关系摆脱“固定系数组合加常数”的范围。
这不表示把矩阵分成几步从来没有用途。分解可能服务于计算、存储或参数组织。但若关心的是对固定输入空间能够表示什么函数,仅凭堆叠这些步骤不能获得超出整体仿射关系的变化。中间若加入不同操作,就必须重新分析。
一种常见操作是ReLU,它对每个数取原值与零之中的较大者:
正值保持,负值变成零。这个规则简单,却不是整个实数空间上的线性变换。例如,1与−1先相加再处理,结果为0;分别处理再相加,结果为1。哪些贡献能够通过,取决于当前输入的正负。PyTorch的ReLU说明给出了逐元素使用这一函数的定义。
一个只有两条中间通道的例子
设输入只是一项实数t。第一步产生两项(t,−t),分别经过ReLU,再把两项相加。最终规则为:
t为正时,第一项保留它,第二项归零;t为负时,第一项归零,第二项保留相反数。因此,两种方向的输入都得到非负的大小。这个结论通过中间两项怎样被选择得到,不能只从前后矩阵的形状看出来。
如果把中间的ReLU省略,只将前后矩阵相乘,就会得到[1,1]乘[1,−1]ᵀ,结果为零。原流程在t=2与t=−2时都输出2,省略后的规则却对所有输入都输出0。两条路径原来会相互抵消;ReLU先阻止负的那条路径进入求和,整体关系便改变了。
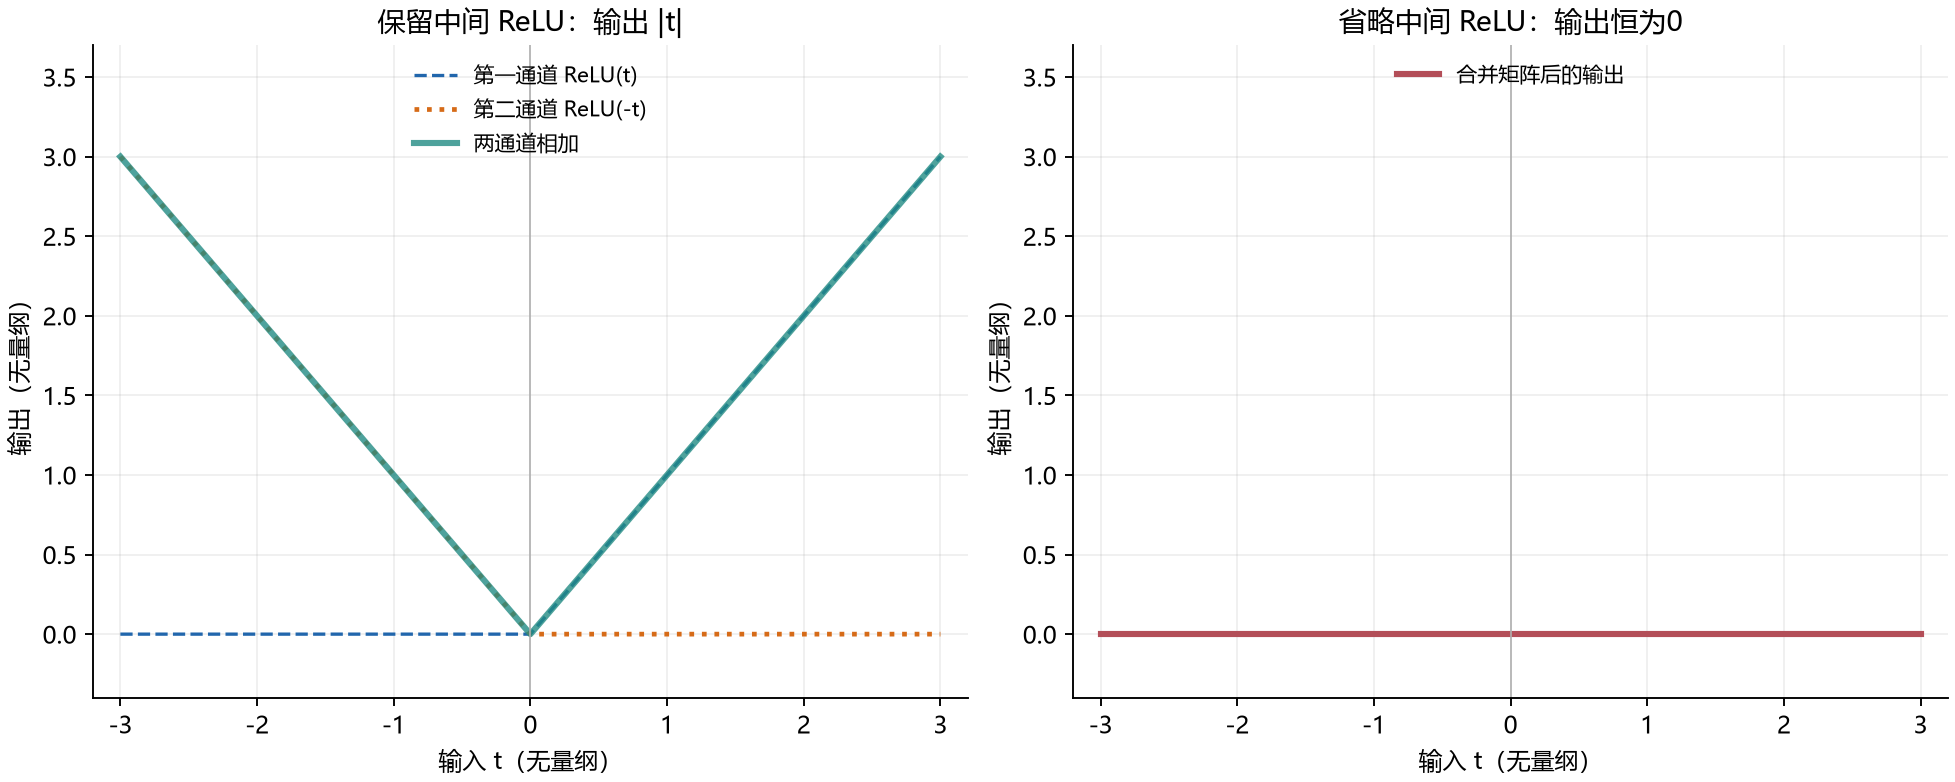
图三:曲线来自本节人为设定的两通道规则,没有训练模型。输入正负改变时,通过的通道不同;右图的零输出对应删去ReLU后只保留矩阵乘法。
用同一组NumPy运算可以核对几个正负输入:
t = np.array([[-2.], [0.], [2.]])
W1 = np.array([[1.], [-1.]])
W2 = np.array([[1., 1.]])
hidden = t @ W1.T
with_relu = np.maximum(hidden, 0.) @ W2.T
merged_linear = t @ (W2 @ W1).T
print(with_relu.ravel())     # [2. 0. 2.]
print(merged_linear.ravel()) # [0. 0. 0.]
这里.ravel()只是把三个单值输出展平为一维数组,便于显示,np.maximum按对应位置与零比较。代码依赖前面已导入的NumPy,不涉及参数学习。它验证的是给定规则的区别,不是任何真实模型的性能结论。
对某一片正负模式保持不变的输入范围,ReLU的作用可能简化为固定的保留或归零;跨越不同范围时,这个选择又会变化。因此不能从几次都得到正中间值的试验,推断所有输入都允许省略激活。类似地,最大值、裁切或依赖输入的权重也要按实际规则判断,不能只因周围有矩阵乘法,就把整段程序一并合成常数矩阵。
十一、把知识用于完成这次图形处理
回到开头三角形。现在小叶可以明确告诉AI:输入每行一个顶点,坐标向右、向上为正,以厘米记录;先按固定横轴拉宽两倍,再绕原点逆时针转90度,最后沿固定画布加(5,1)。坐标方向、单位和操作要求确定几何含义,行排列与矩阵约定确定实现方式。
将前面算出的复合矩阵用于整批顶点,再加平移:
offset = np.array([5., 1.])
final_vertices = X @ combined.T + offset
print(final_vertices)  # [[4. 3.], [4. 7.], [3. 3.]]
restored = np.linalg.solve(combined, (final_vertices - offset).T).T
print(np.allclose(restored, X))  # True
固定的两分量offset在这里加到每一行,因此三个顶点分别落在(4,3)、(4,7)、(3,3)。第一、第二顶点之间的原水平边长2厘米,拉宽后长度变成4厘米,转向后成为竖直边;原来的竖直短边则转成向左的1厘米边。顶点数值与整体外形符合同一项操作要求。
小叶还会检查原点经过完整操作后是否到达(5,1),以及一个原来向右的位移是否变成向上两倍。前者检查固定偏移,后者检查线性部分。需要撤销时,先减偏移再求解复合线性关系,代码最后的重构核对已经执行了这一思路。
这一轮处理因此可以交给绘图程序按原顶点顺序连线。若后续要改变图形中心、改用向下为正的像素坐标,或者加入像素裁切,就把新增条件写进下一段处理,再检查它是否还能合并。眼前已经得到的结论是具体的:当前三个顶点、变换顺序、固定平移与恢复关系相互一致。
线性变换提供了一种从基本输入理解全部行为的方法;矩阵把这些基本输入的去向记下来;矩阵乘法则把前后处理的贡献接起来。看懂这三者的关系,我们就能沿着数据流判断AI写出的计算在做什么,哪些步骤能合并,哪些约定或非线性操作必须单独保留。
十二、练习与参考分析
练习一:基本输入决定了哪一个矩阵
某个线性变换把(1,0)变成(1,2),把(0,1)变成(3,−1)。写出它的矩阵,并求(2,−1)的输出。另一个黑箱也在这两个基本输入上交出相同结果,能否仅凭这一点断定它对所有输入都相同?
参考分析: 两个输出分别作第一、第二列,矩阵为[[1,3],[2,−1]]。输入(2,−1)由两份第一基减去一份第二基组成,输出为2(1,2)−(3,−1)=(−1,5)。这既是矩阵乘法,也是按已知贡献合成。
对另一个已经确认线性的实现,可以据基向量上的相同作用判定全部输入相同;对任意黑箱则不够。例如,在这个线性结果上额外增加(xy,0),两个标准基输入的xy都为零,测试仍然通过,但输入(1,1)时多出(1,0)。遗漏的是线性这一前提,不能靠两个样本暗中补上。
练习二:换顺序与换括号是两种操作
设S=diag(2,1),H=[[1,1],[0,1]]。对输入(1,2),分别计算先S再H、先H再S的结果。若还要经过另一个矩阵R,为什么可以在RHS中改变括号,却不能据此交换H与S?
参考分析: 先S把(1,2)变成(2,2),再H得到(4,2);先H得到(3,2),再S得到(6,2)。HS=[[2,1],[0,1]],SH=[[2,2],[0,1]],不同顺序确实改变了横向贡献。
R(HS)与(RH)S都保持先S、再H、最后R,结合律只改变中间乘积如何计算。把RHS改成RSH则改变了S与H的作用顺序。即使某个特殊R又把两种差别压掉,也不能据此宣称H与S本来可交换。
练习三:中间记录换序以后怎样接回去
仍用正文两亮度读数的A、B。输入(4,2)得到中间记录(8,8,2)。接口现在把中间记录改按“第三项、第一项、第二项”交给下一步,但下一步仍直接使用原B。结果会是什么?怎样修改B,才能保持原处理结果?
参考分析: 新中间记录为(2,8,8),原B直接处理会得到(18,0),不再是(12,6)。问题在于B的系数位置仍按旧字段顺序解释。
在新顺序下,旧第一项位于第二个位置,旧第三项位于第一个位置,因此第一个输出应取两份新第一项加一份新第二项;第二个输出应取新第三项减新第一项。新的矩阵为[[2,1,0],[−1,0,1]],作用于(2,8,8)后恢复(12,6)。这里调整的是字段对应,不能只凭三个数的数量一样沿用旧矩阵。
练习四:绕指定中心拉伸
小叶要围绕c=(1,2)做横向两倍拉伸,中心保持不动,仍用S=diag(2,1)。点(3,4)应去哪里?若AI写成Sx+c,问题是什么?请给出展开后的固定偏移,并说明怎样由变换后的位置恢复输入点原来的位置。
参考分析: 应先求相对中心的位移(2,2),拉伸为(4,2),再加回中心,得到(5,4)。完整规则是S(x−c)+c=Sx+(c−Sc),其中Sc=(2,2),固定偏移为(−1,0)。
错误的Sx+c会把(3,4)送到(7,6),也会把中心c送到(3,4),没有保持中心不动。恢复某个变换后位置q时,用c+S⁻¹(q−c),即先以中心为起点撤销拉伸,再恢复位置。整个计算中画布坐标始终固定,c是拉伸的中心。
练习五:形状正确的批量代码是否就正确
两条记录按行存为X=[[1,2],[3,4]],列向量规则为y=A x,A=[[1,2],[0,1]]。正确批量结果是什么?若程序改成X A,或改成P X,其中P=[[0.5,0.5]],它们分别在做什么?
参考分析: 应计算X Aᵀ,得到[[5,2],[11,4]]。每行的第二个分量保留,第一项增加两份该行第二分量,符合指定线性变换。
X A会得到[[1,4],[3,10]],仍为2×2,却实施了另一种组合。P X则把两条记录求平均,得到[[2,3]],它混合的是样本,不是分别变换每个样本。右乘和左乘的区别,应由输入输出对象判断,不能只比较是否使用了同一个乘法符号。
练习六:有偏置、没有激活,能不能合并
一个单输入处理先算h=2t+1,再算y=3h−4。请合并成一个规则。若在两步之间把h改成ReLU(h),是否仍可用同一个全局仿射规则代替?用不同输入范围解释,再给一组数核对。
参考分析: 没有激活时,y=3(2t+1)−4=6t−1,前一步偏置1先被后一系数放大到3,再减4,最终偏置为−1,不能简单写成1−4。
加入ReLU后,y=3max(0,2t+1)−4。当t≥−0.5时,结果仍为6t−1;当t<−0.5时,中间值归零,结果固定为−4。整个实数范围上的关系有不同的变化率,不能用同一个仿射式表示。
例如t=0时,两种流程都输出−1,只测这一点会看不见差异;t=−1时,有激活的输出为−4,没有激活的输出为−7。局部范围内可以简化,不等于可以在全部输入上删去决定通道是否通过的步骤。