小叶想把资料中的彩色图片交给一个图像处理程序,批量提取其中的内容。他请AI协助写了读取和整理代码,图片文件能打开,程序也确实读出了数字,提交时却提示输入形状不符合要求。
AI建议修改几处括号里的数字。报错消失了,小叶却发现,送进去的图像颜色和排列都不对。文件没有缺少,数值总量也没少,为什么换一下“形状”会出问题?
这里需要理解的不只是数组有多大,还包括每一层排列在区分什么。一张图片有行、列和颜色通道,一批图片还要区分是哪张图片。程序若把“颜色通道”当作“图片宽度”来读,即使能够完成运算,做的也不是小叶原先想做的事。
本章从这次交接讲起,认识张量、轴和数据形状,并追踪几个具体数值怎样在不同排列之间移动。我们会区分重排、合批、汇总和按轴重复使用规则,让“程序可以运行”进一步变成“程序在处理正确的对象”。图片和数值都是教学构造,不是对某个AI产品的实测。
一、从一张灰度图,到一批彩色图
多一个要区分的方面,就多一个索引
上一章用一个矩阵记录灰度小图。要找到其中一个数,需要知道它在哪一行、哪一列。例如,第二行第三列对应一个像素位置,该位置的数值说明灰度。
彩色图需要继续说明,在这个位置上读的是哪一种颜色通道。在本章采用的RGB方式中,每个像素包含红、绿、蓝三个数。图像仍是平面的,并没有因为增加颜色通道就变成一个立体物体;多出来的是记录颜色时需要区分的一个方面。
为了能够逐项追踪,我们先用一张只有两行、三列像素的小图。每个格子里的三个数按红、绿、蓝排列:
| 位置 | 第一列 | 第二列 | 第三列 |
|---|---|---|---|
| 第一行 | (10,110,190) | (20,120,200) | (30,130,210) |
| 第二行 | (40,140,220) | (50,150,230) | (60,160,240) |
这些数使用0到255的通道取值范围。它们故意安排得容易辨认:红色通道是10到60,绿色是110到160,蓝色是190到240。这样,当某个程序把110送进红色通道时,我们容易发现它属于哪里。
只看红色,可以取出一张两行三列的数表;看绿色或蓝色,也各有一张同样大小的表。把这三个通道与空间位置组织在一起,就需要三个索引:行、列、通道。
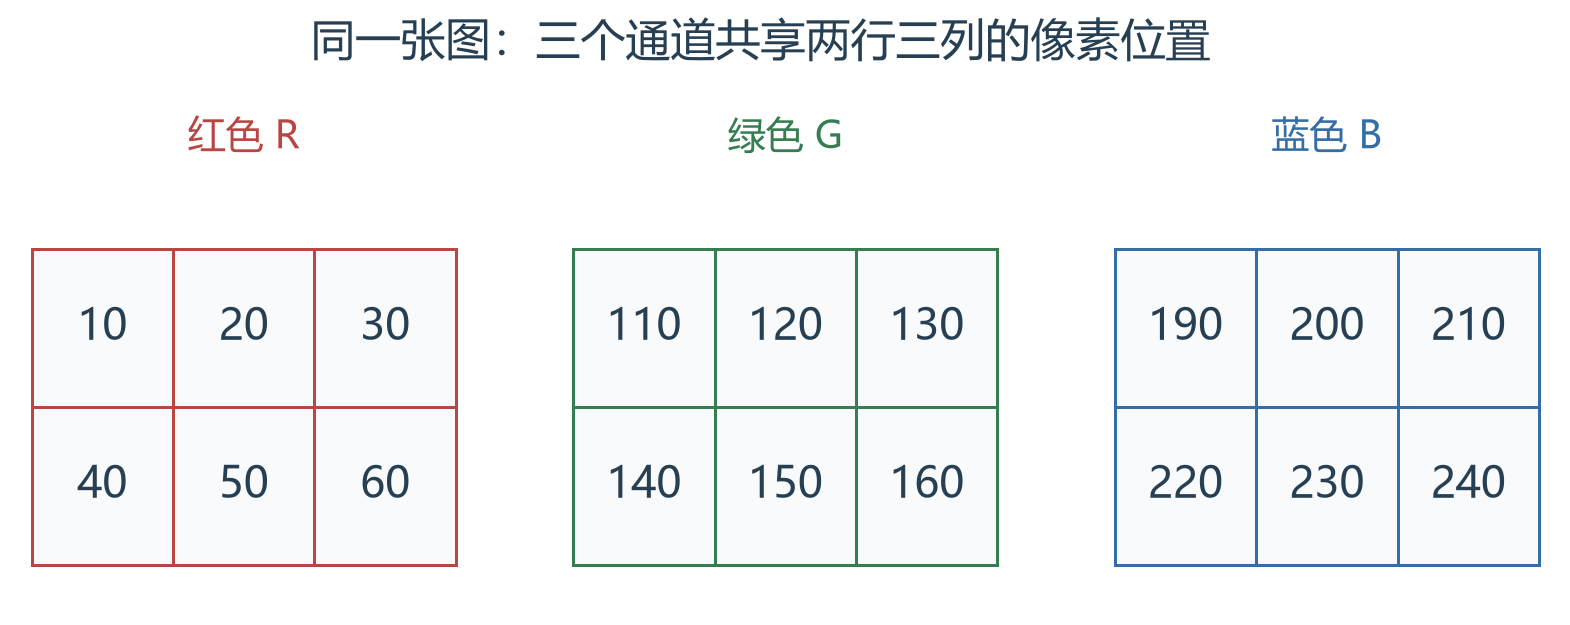
图一:三张表不是三张不同的照片,而是同一张小图的三个颜色通道。三个通道在同一行同一列的数,共同描述那个像素。
现在再加入第二张图片,它的每个通道值都比第一张对应位置大5,例如左上角为(15,115,195)。当两张图片放在同一批里,要唯一找到一个数,就需要依次确定:哪张图、哪一行、哪一列、哪个颜色通道。
张量在这里指什么
在常用AI计算工具里,张量可以先理解为按多个轴组织数值的数组。轴就是其中一个排列方向:本例依次用图片、行、列、通道四个轴区分数值。
一个标量没有需要逐项选择的轴,一组数构成的向量有一个轴,矩阵有两个轴。继续增加轴,就能够记录彩色图、图片批次、视频帧等具有更多层次的数据。张量并不要求我们在脑中画出对应轴数的物理空间。
数学和物理也会从更一般的角度研究张量。本章采用AI数组工具中的用法,先把数据排列与操作弄清楚。这样已经足以理解大量实际的数据处理工作,不需要先进入另一套抽象理论。相关入门定义可见TensorFlow的张量指南。
值得留意的是,张量不是一种知道业务含义的智能容器。程序看见四个轴,通常不会自己知道哪一个代表图片、哪一个代表通道。小叶需要提供或遵循这些约定,才能使同一批数字在不同环节保持一致的解释。
二、形状:每个轴有多长,以及整个数组有多少数
把四个轴的长度写出来
我们的批次包含两张图,每张图两行、三列,每个像素三个颜色通道。按“图片、行、列、通道”的轴顺序,形状写作:
第一个2是图片数量,第二个2是每张图的高度,第一个3是宽度,最后一个3是通道数。四个长度不能脱离位置解读:同一个数字2在这里分别承担了两个不同的角色。
程序文档中常用B或N表示批次大小,H表示高度,W表示宽度,C表示通道数。本章把这种排列简称为BHWC,即“批次、高、宽、通道”。这里的字母是轴的含义说明,括号里的数字是本批数据在这些轴上的实际长度。
四个轴意味着这个数组通常被称为四维数组,或四阶张量。有些工具把轴的个数叫作rank。这个用法是在数轴,与后面课程中表示线性独立程度的“矩阵的秩”不是同一个问题。遇到“维度”或rank时,先看对方是在说轴的个数、某条轴的长度,还是别的数学性质。
形状也不能单独表达全部含义。同样的(2,2,3,3),可以被解释成两次实验、两个时点、三台传感器、每台三个读数。即使限定为图像,最后三个通道还可能按RGB或BGR排列。长度相同不代表颜色顺序也一致。
元素总数为什么是各轴长度相乘
每个像素需要三个数,每张图有两行三列共六个像素,所以一张图有18个通道数值。两张图共有36个:
这一乘积是在逐层数有多少位置。每增加一张相同尺寸的图,就增加一整张图需要的18个数;每增加一列,则每一行、每张图、每个通道都要补上对应位置。
如果把两张图分别展开为向量,一行一张图,可以得到形状(2,18)的矩阵,元素总数仍为36。若有人想直接把这36个数改成(2,20),就需要40个位置,原数据不足以填满。普通的重塑形状操作不会自动决定补哪四个数。
元素数匹配是检查形状变换的一条必要线索,但它只回答“位置够不够”,没有回答“原来每个数应该放在哪里”。开篇的问题恰恰可能出现在总数完全匹配的情况下,后面会用具体像素来看。
数据类型不改变形状,却会改变数怎样存储
另一个经常与形状同时出现的词是数据类型,通常写作dtype。它规定每个元素按哪种数字格式存储,例如8位无符号整数或32位浮点数。
本例每个通道值在0到255之间,可以用每个元素占1字节的8位无符号整数存储。36个元素的纯数值数据占36字节;改用每个元素占4字节的32位浮点数,纯数值数据就占144字节。这里不计数组对象自身、额外缓存等开销。
改为浮点数,形状仍是(2,2,3,3),图片也没有因此变多。但若后续要把通道值除以255,得到0到1之间的小数,浮点表示就能够用于保存这类结果。数据类型决定数值表示方式,数值缩放则改变数值范围,这是两个不同的操作。
对一批较大的图像,这种数量关系也能帮助估计数据规模。例如另设一批8张224×224的RGB图,按32位浮点数存储,仅原始批次数组就需要4,816,896字节,约4.82 MB,这里的MB按一百万字节计算。实际模型运行还会保存参数和中间结果,因此这个数字只是输入数组的规模,不是总内存需求。
我们不需要在这一章研究所有数字格式。对小叶的交接而言,先说清轴的含义与长度,再确认dtype和取值范围,就已经能消除“同样形状为什么仍读错”的一部分原因。
三、索引与切片:取出一部分以后,还剩哪些轴
下面用一小段NumPy代码保存刚才的图片。NumPy是用于数值数组计算的Python工具;不熟悉程序设计的读者可以先看每一步取出的对象与形状,代码用于把这种关系具体展示出来。
本章程序索引从0开始。因此,第一个位置编号0,第二个位置编号1。这与日常所说“第一张图”“第二行”不是同一种编号写法,下面会把二者对应说明。
import numpy as np

first = np.array([
    [[10, 110, 190], [20, 120, 200], [30, 130, 210]],
    [[40, 140, 220], [50, 150, 230], [60, 160, 240]]
], dtype=np.float32)
second = first + 5
T = np.stack([first, second], axis=0)
print(T.shape)  # (2, 2, 3, 3):图片、行、列、通道
这里先把两张图放进同一批,stack怎样增加批次轴将在第五节展开。现在先看T已经拥有的四个轴。
每给一个确定位置,就沿那个轴选中一项
第一张图、第二行、第三列的绿色值,在日常语言里需要四项说明。在代码中对应:
print(T[0, 1, 2, 1]) # 160.0
第一个0选第一张图;后面的1和2选第二行第三列;最后一个1选RGB中的绿色。四个轴上的位置都确定以后,取到一个单独的数。若只给图片编号T[0],则取到第一张完整图片,形状变成(2,3,3),留下行、列和通道三个轴。
这可以用“尚未选定什么”来理解。只选定是哪张图,还没有选图中的位置和通道,所以结果仍包含后面三层排列。所有位置都选定以后,才得到标量。
假如小叶需要取第一张图的整个绿色通道,他不固定行列,只固定图片与通道:
green = T[0, :, :, 1]
print(green)
# [[110. 120. 130.]
#  [140. 150. 160.]]
冒号:在这里表示保留该轴上的所有位置。结果是两行三列的绿色数表,与图一中绿色通道相同。每个绿色通道值仍对应原图中的同一个像素位置。
保留一张图,与保留大小为一的批次
T[0]取出一张图,通常不再保留批次轴。如果下游程序仍要求输入必须是一批图片,即使本次只有一张,也应该保留一个长度为1的批次轴。
one_image = T[0]
one_batch = T[0:1]
print(one_image.shape)  # (2, 3, 3)
print(one_batch.shape)  # (1, 2, 3, 3)
0:1表示从编号0开始、到编号1之前,只保留第一个位置,同时保留这一层轴。两种结果包含同样18个数,区别在于是否还明确保存“这是一批,批次里只有一张”的组织方式。
因此,长度为1的轴不一定是无用的包装。它可以让单张图与多张图遵循同一个接口,后续程序始终沿第一个轴逐图处理。随手删除全部长度为1的轴,可能把这个约定一起删掉。
对程序建议的检查也可以更具体。若AI建议增加或删除一条轴,小叶可以追问它代表哪一层对象,以及下游现在按几层索引来读数据。只说“加一个维度就好了”,还不足以解释为什么该加在那个位置。
四、重塑与换轴:为什么元素总数相同,仍可能把图片弄乱
开篇的问题现在可以具体说明了。小叶已经把图像保存为BHWC,但我们假定的下游接口要求BCHW:先区分图片,再区分通道,然后是行和列。原来每个像素旁边紧接着记录RGB,现在需要先查看一张图的整个红色通道,再查看绿色和蓝色通道。
两种排列都可以完整保存图片。转换的目标是让同一个通道读数出现在下游约定的位置,图像内容本身不应发生变化。
先给出要保持的对应关系
用T表示原批次,Y表示转换后的批次,下标b、h、w、c依次代表图片、行、列、通道的位置编号,均从0开始。正确关系是:
这条式子记录的是同一个数怎样换一种地址。图片、空间位置和颜色身份都保持,只是通道编号被提前了。例如,第一张图第二行第三列的绿色仍然应该是160。原来按“图、行、列、通道”找它,现在按“图、通道、行、列”找它。
在NumPy里,这种把已有轴调整顺序的操作可以用transpose完成:
Y = T.transpose(0, 3, 1, 2)
print(Y.shape)          # (2, 3, 2, 3):图片、通道、行、列
print(Y[0, 1, 1, 2])   # 160.0
print(Y[0, 0])
# [[10. 20. 30.]
#  [40. 50. 60.]]
括号里的(0,3,1,2)是原轴的编号顺序:原来第0轴的图片仍放最前,原来第3轴的通道放到第二位,然后依次放原来的行轴和列轴。它不是把数据换成0、3、1、2,也不是设置各轴长度。换轴规则可参见NumPy的transpose文档。
reshape做的是另一件事
重塑形状通常写作reshape。在本章使用的NumPy默认C顺序下,可以把它理解为先按“最后一个轴变化最快”的索引顺序读出数,再按同样规则填入新形状。它会遵循这种读写顺序,却不会因为某条新轴长度为3,就自行识别它应当放RGB通道。
以第一张图为例,先读第一个像素的三个通道,再读第二个像素的三个通道,开头会得到:
10,110,190,20,120,200,30,130,210,……
如果直接把整个批次重塑成目标形状,程序可以成功:
wrong = T.reshape(2, 3, 2, 3)
print(wrong.shape)  # (2, 3, 2, 3)
print(wrong[0, 0])
# [[ 10. 110. 190.]
#  [ 20. 120. 200.]]
按照下游BCHW的含义,wrong[0,0]应该是第一张图的整个红色通道。但实际进入这个位置的是刚才顺序中的前六个数,其中混进了绿色和蓝色。它的形状与正确Y完全相同,元素总数也相同,甚至原来的36个数一个都没少,颜色的对应关系却已经被弄错。
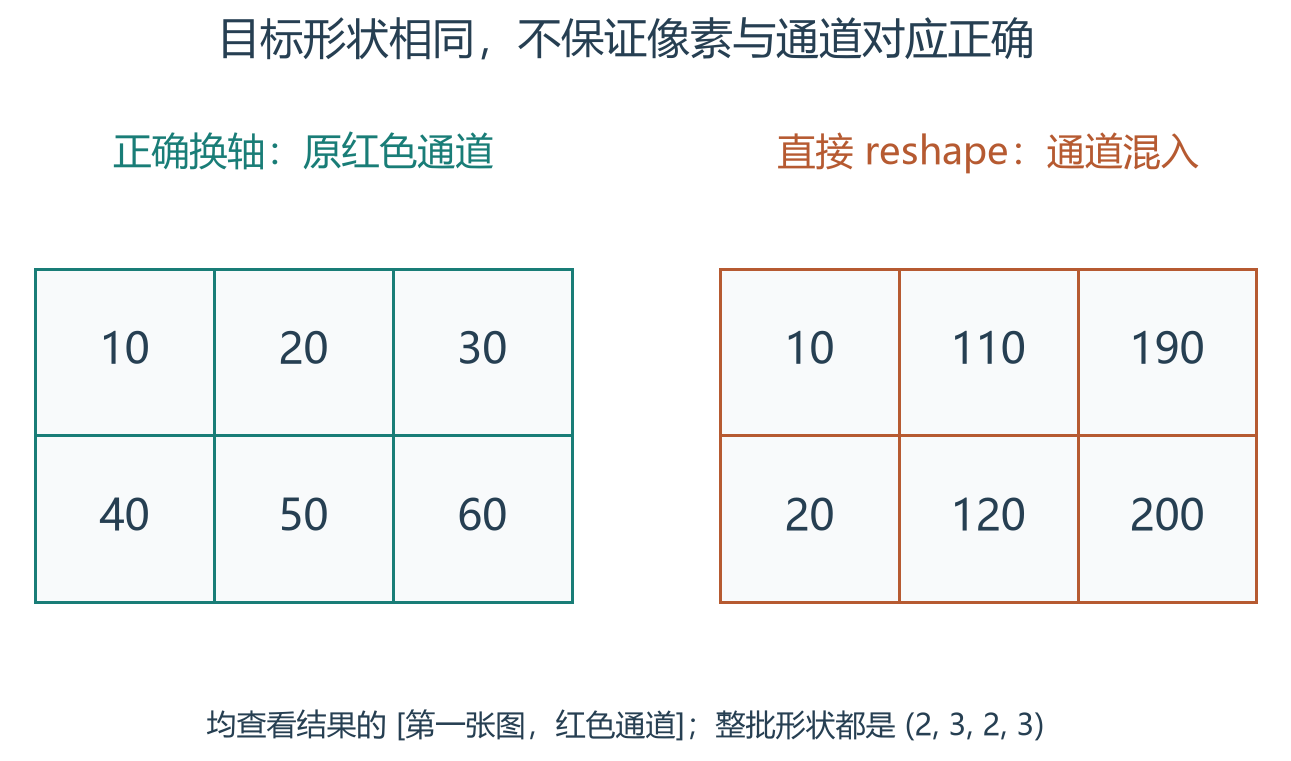
图二:两种结果都具有BCHW的目标外形。查看第一张图被当成红色通道的六个数,可以看见它们实际不同。
因此,reshape并不是“任何形状报错的修复按钮”。当任务是把一张图的全部数重新分组,且新旧分组正好遵循已经说明的读取顺序时,它很有用;当任务是让原来的颜色轴换位置,就需要按轴的语义重排。
怎样用对重塑,而不是回避它
假如小叶确实要把每张图的18个数作为一个长向量,保留每张图的边界,可以写:
flat = T.reshape(2, 18)
restored = flat.reshape(2, 2, 3, 3)
print(np.array_equal(restored, T))  # True
此时,一张图内部按原来的读取顺序展开,恢复时按相同顺序填回原形状,所以能还原。这里的成功来自明确保留了每张图的边界、原形状和顺序,不是因为所有形状之间都能够随意替换。
NumPy也允许用一个-1让程序根据元素总数推算那条轴的长度,例如T.reshape(2,-1)会推得第二条轴长度18。它只是在已知总量中补出一个长度,不会推测这个长度代表特征、像素还是时间点。关于顺序与自动推算的细节,可见NumPy的reshape文档。
重排是否需要复制底层数据,是另一层存储实现问题。某些操作可以通过改变数组的查看方式实现,另一些需要复制。本章先按逻辑索引解释数值对应关系,不把“换轴”简单等同于一定搬动所有字节,也不把“重塑”说成永远没有内存成本。
五、增加批次轴,与沿已有轴拼接
小叶已经知道怎样在四个轴之间换位置。现在回头看,两张图片最初是怎样进入同一个批次的。
stack:增加一层“选哪一个”的组织
两张单图的形状都是(2,3,3),各自只有行、列和通道。要同时保存两张,并能分别取回,便需要在外面增加一个图片轴。
前面使用的np.stack([first,second], axis=0)就是沿新轴堆叠:原来每张图的三个轴保留,最前面新增一个长度为2的轴,结果成为(2,2,3,3)。新的第一个位置放第一张图,第二个位置放第二张图。
这里“堆叠”是数据组织上的说法。它不表示在画面中把两张照片真的叠印在一起,也没有对像素做平均。我们只是为两张完整图片各保留一个可选择的位置。
如果选择把新轴加在其他位置,得到的形状和轴含义也会相应不同,所以仍应由下游的约定决定。axis=0不是任何任务都必须照抄的写法。操作定义可见NumPy的stack文档。
concatenate:让已有的一个轴变长
拼接可以沿已有轴继续接数据,NumPy中常用concatenate。它不增加新的轴,而是把指定轴的长度相加,其他轴需要能够对应。
对两张单图,如果沿第0轴拼接,连接的是它们的行:
tall = np.concatenate([first, second], axis=0)
print(tall.shape)  # (4, 3, 3)
结果不再是带两张图片位置的批次,而是一张在数组结构上有四行、三列、三个通道的长图。它可以用于有意上下拼图的任务,但与“让程序分别处理两张图”不是同一个输入。
当输入已经是两个批次,情况又不同。另设第一批2张、第二批5张,二者每张图尺寸及通道规则相同。它们的形状分别为(2,H,W,C)和(5,H,W,C),沿现有批次轴拼接,结果是(7,H,W,C)。这一次增长的是图片数,行列没有变。
同一个操作为什么前面是在接图片高度,后面是在合并图片批次?因为第0轴原先的含义不同。操作只沿指定轴执行,轴在任务里代表什么,需要从输入约定里判断。已有轴拼接的条件可见NumPy的concatenate文档。
合批以后,文件编号也要沿相同顺序合并。如果数值先接第一批再接第二批,编号却反过来接,模型结果可能很好,回写到文件时仍然会张冠李戴。形状帮助维护排列,编号则把排列中的位置连接到真实文件。
六、沿哪个轴汇总,决定保留什么结果
小叶想检查两张小图的通道数值有没有按预期读入,打算分别计算每张图红、绿、蓝三个通道的平均值。这个目标仍然区分图片和通道,却不再需要区分同一通道中的具体行列位置。
这种沿一些轴求和、求均值等操作,常被称为归约。可以先把它理解为:沿选定的轴汇总,让多个位置共同形成一个结果。真正需要决定的是哪些区别要汇总掉,哪些区别要保留。
对空间位置求平均,保留图片和通道
对BHWC形状的T,行轴编号1,列轴编号2。每张图的每个通道在这两条轴上共有六个位置,对它们求平均:
means = T.mean(axis=(1, 2))
print(means.shape)  # (2, 3):图片、通道
print(means)
# [[ 35. 135. 215.]
#  [ 40. 140. 220.]]
第一张图的红色值从10到60,平均为35;其余两通道分别平均为135、215。第二张每个对应值增加5,所以各通道平均也增加5。结果有两行,是因为两张图仍然分开;每行有三个数,是因为三个通道仍然分开。
若只沿第0轴求平均,则会把两张图在相同位置、相同通道的值平均,得到(2,3,3),保留行、列和通道,却失去了两张图的分别记录。这种结果可以作为有意的逐位置平均,但不能冒充刚才要的“逐图通道均值”。
由此可见,看到mean还不足以知道程序算的是什么平均。要查看它沿哪些轴汇总,以及那些轴在当前排列中代表什么。BHWC改成BCHW以后,行列的轴编号也变了,原来的数字不能继续无条件照用。
汇总以后,为什么有时仍保留长度为一的轴
如果只展示均值,(2,3)已经够用。但小叶有时还想让每张图的每个像素都减去本图对应通道的均值。为了让后续操作容易对应,可以让求平均时被汇总的行列轴保留下来,长度设为1:
kept = T.mean(axis=(1, 2), keepdims=True)
print(kept.shape)  # (2, 1, 1, 3)
每张图仍有三个通道均值,没有凭空增加信息。中间两个1表示这里不再逐行逐列变化,每个通道只保留一个平均结果。它保留了原先四个轴的位置,使接下来把同一个均值用于该图全部空间位置时,不容易接错轴。
这里的长度为1,又一次承担了明确作用。它既不是增加图像分辨率,也不是补出新样本,而是把“这个值不随该轴变化”记录在形状里。下一节会继续说明,这类长度为1的轴怎样让同一个值用于不同位置。
七、广播:把一条规则用于很多位置,怎样避免用错方向
小叶想试验一项简单的通道运算:让所有图片、所有位置的红色值减10,绿色值减100,蓝色值减180。这只是为了观察数组对应关系而指定的教学操作,不是推荐给所有图像使用的增强方法。
一种做法是为每一个像素都准备一份(10,100,180),然后逐项相减。可是我们已经知道,每个像素都使用同一组通道规则,没有必要手工把它抄写几十遍。
广播就是数组工具按照规定的形状匹配规则,把较少的一组值用于更多位置。在T的BHWC排列中,最后一个轴正好是三个颜色通道,因此可以写:
offset = np.array([10, 100, 180], dtype=np.float32)
adjusted = T - offset
print(adjusted[0, 0, 0])  # [ 0. 10. 10.]
第一个像素原来是(10,110,190),三个通道分别减去对应值以后得到(0,10,10)。其他像素也按同样的颜色对应关系处理。程序计算的仍然是每个位置的结果,只是我们不用把重复规则显式写满整个批次。
从右往左匹配形状
NumPy的广播从形状的最右侧开始对应。两条对应轴的长度相同,或者其中一条长度为1,就能够按这条轴配合;缺少的左侧轴按长度1对待。这里先讨论各轴长度为正的普通数组。
把T与偏移向量对齐,可以看到:
T的形状:       2   2   3   3
偏移的形状:               3
补齐左侧:      1   1   1   3
轴的含义:    图片  行  列  通道
最后的三个值分别配三个通道。前面的三个1说明,图片、行和列改变时,这组偏移规则都不跟着改变。因此,同样的通道规则能够应用到每一张图、每一个空间位置。
这里可以把长度1想象成“这一方向上只提供一套值,供各个位置使用”。这是帮助理解的说法,实际实现通常不必先把小数组完整复制成大数组。运算输出及其他中间结果仍可能占用内存,不能因此认为广播总是没有存储成本。规则与例子可见NumPy的广播说明。
最难发现的错误:广播成功,含义却不对
现在使用已经换为BCHW的Y。它的形状是(2,3,2,3),最后一条轴代表图片的三列,通道已经移到第二条轴。
如果仍然直接写Y-offset,会不会报错?本例恰好不会,因为图片宽度也是3,偏移向量的三个数可以沿最后一条轴匹配。但这次它们被依次用于第一列、第二列、第三列,而不是红、绿、蓝。
wrong_adjusted = Y - offset
print(wrong_adjusted[0, :, 0, 0])  # [  0. 100. 180.]
这行代码取第一张图左上角的三个通道。因为它们都在第一列,错误的广播都给它们减了10,所以得到(0,100,180)。这与原先要求分别减10、100、180之后的(0,10,10)不同。
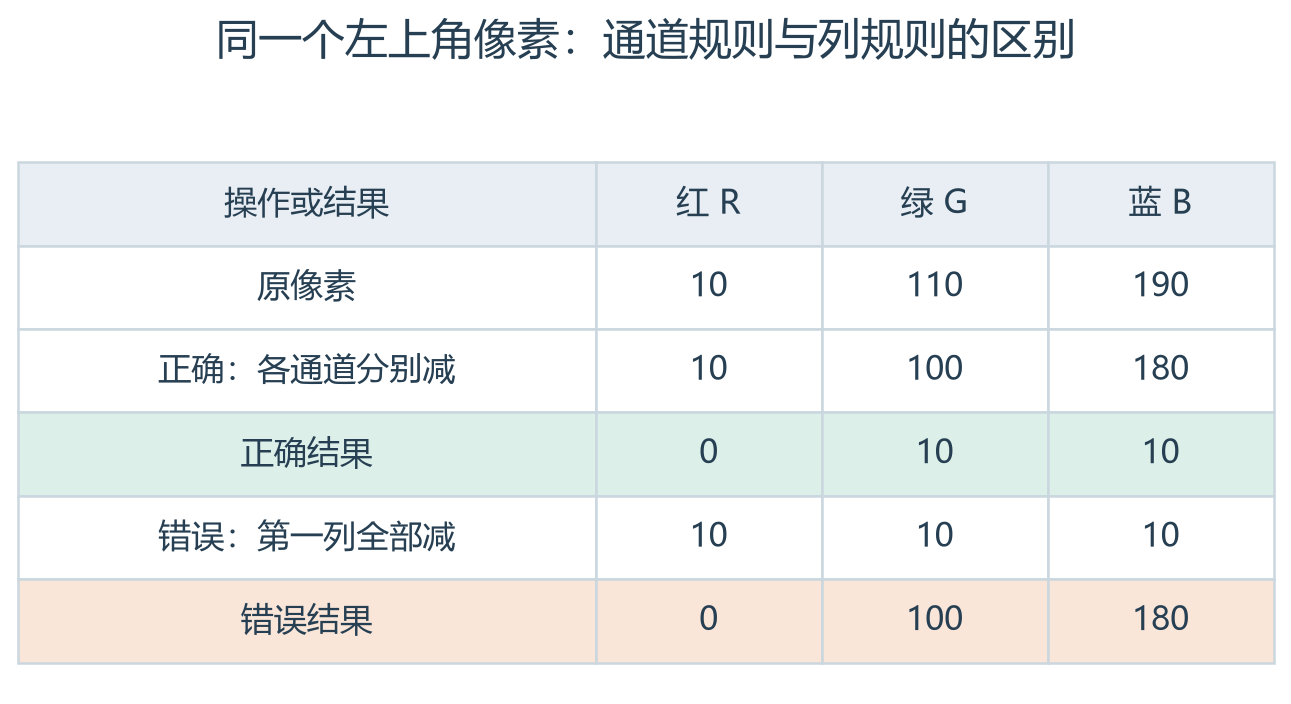
图三:两个运算都能运行。正确规则按颜色选择偏移;错误规则按列选择偏移,使第一列所有颜色都减10。
同一个偏移向量,在两种轴顺序下都能算,实际作用对象却变了。如果换一张宽度不等于3的图,程序可能直接报错;宽度恰好为3时,它反而可能安静地输出错误结果。因此,错误提示只是发现问题的一种方式,不能替代对轴含义的检查。
正确做法是在BCHW中把偏移向量排到通道轴:
channel_offset = offset.reshape(1, 3, 1, 1)
correct_adjusted = Y - channel_offset
print(correct_adjusted[0, :, 0, 0])  # [ 0. 10. 10.]
长度3现在对应通道,图片、行、列都用长度1表示“沿这些方向复用”。这也展示了reshape的一个恰当用途:为已经明确是三个通道规则的向量,在图片、行、列的位置增加长度为1的轴,没有试图让它替我们发现颜色的身份。
本例从创建数组起就使用浮点类型,中间计算允许出现负值。要把结果再作为图片显示或保存,还需要考虑后续接口的范围要求;形状调整本身不会替我们完成这些数值处理。
八、不同长度的数据,怎样进入共同批次
图片案例中的两张图尺寸相同,能直接组成一个规则批次。小叶处理文字资料时,会遇到另一个常见情况:不同文件含有不同数量的段落,或者不同文本被分成了不同数量的词元。词元是模型分词后使用的基本文本单位,可能是一个词,也可能只是词的一部分。Hugging Face的分词说明给出了这类例子。怎样把长度不同的记录放到一起?
如果每个位置都用同样长度的向量表示,一份有3个位置,另一份有5个位置,直接叠成一个普通的稠密张量时就会遇到缺口。所谓稠密张量,在这里指每条轴按固定长度完整排列的普通数组:同一批中的每条序列都需要有相同的可用位置数。
填充补的是位置,不是真实内容
一种常用处理是填充:在较短的序列后面加入占位,让它达到本批统一的长度。假定两份文本分别有3个和5个有效位置,可以给第一份补两个位置,组织成长度都为5的批次。
如果每个位置由128个分量表示,填充后的形状可以是(2,5,128),对应“文本、位置、每位置的分量”。原来共有8个有效位置,现在数组中有10个位置,其中两个只是为了整齐排列增加的占位。
数组的元素总数成为2×5×128=1280,但不能据此说文本增加了两个有效词元。位置被补齐,内容并没有因此增长。小叶还需要保存哪些位置有效、哪些只是填充。
掩码把有效位置明确标出来
掩码是一组用于控制哪些位置参与某项处理的标记。在本章的约定中,1表示有效位置,0表示占位。上面两份文本的掩码可写成:
M的形状是(2,5),仍然对应文本与位置。每个标记说明那个位置整体是否有效,不需要为128个分量各重复写一次相同状态。实际模型对掩码的取值和形状可能有不同约定,使用时应按接口说明转换;这里先用简单标记理解作用。
为了看见填充对计算的影响,我们另用标量记录每个有效资料片段的预计核验分钟数。第一份的三个片段分别为2、4、6分钟,第二份的五个片段分别为1、3、5、7、9分钟。把第一份补零以后得到:
durations = np.array([[2, 4, 6, 0, 0], [1, 3, 5, 7, 9]],
                     dtype=np.float32)
mask = np.array([[1, 1, 1, 0, 0], [1, 1, 1, 1, 1]],
                dtype=np.float32)
averages = (durations * mask).sum(axis=1) / mask.sum(axis=1)
print(averages)  # [4. 5.]
第一份的有效核验总量是12分钟,平均应当按三个真实片段来算,得到4分钟。如果把补上的两个位置也当成片段,直接对五个位置平均,就会得到2.4分钟。记录长度增加了,原来的三项工作没有变轻;变化来自把占位错误地计入了分母。
在这个计算中,掩码一方面排除填充位置的数值,另一方面告诉我们应该按几个有效位置求平均。只把填充值写成0,并不能自动解决平均值的分母问题。示例的两份资料都有有效片段;若某份一个有效位置都没有,需要单独约定如何处理,不能直接除以0。
还要区分真实的零与填充的零。如果某个真实片段的待核验耗时已经确认是0,它仍然是一个有效片段,对应掩码应为1。有效状态来自记录规则,不能只凭数值是否为零来猜。掩码与填充的基本作用可参见TensorFlow关于masking和padding的说明。
不一定所有数据都要补到全库最长
小叶有许多文本时,如果把每份都补到整个资料库最长文件的长度,短文件可能携带大量占位,增加计算和存储。可以按长度接近的资料分组,每批补到适合本批的长度;也可以使用支持不规则长度的数据结构,或逐份处理。选择取决于后续工具支持什么,以及怎样组织更合适。
另一种做法是只保留前面一定数量的位置,即截断。它能限制形状,却会删除超出部分的内容,不能与填充混为一谈。若被截掉的是一个关键结论,程序仍可能正常运行,回答所需的信息却已经不在输入里了。
对图片统一尺寸也需要类似判断。补边、缩放和裁剪都会影响输入形状,但作用不同:补边增加边缘占位,缩放改变采样尺寸,裁剪只保留选定区域。应该根据识别任务决定怎样处理,不能为了凑出指定形状就默认随便采用一种。
九、把本章知识用于一次完整的数据交接
回到开篇,我们把下游条件明确下来:本例接口接受BCHW排列、RGB通道顺序、32位浮点数,以及0到1之间的通道值;输入中的每张图已经具有所需尺寸。这里只处理本章两张微型图,不借用某个实际产品的默认规则。
小叶手上的T是BHWC排列,RGB顺序已经正确,dtype也是32位浮点,但通道值仍在0到255之间。现在需要做的转换有两项:把颜色轴移到图片轴之后,再把每个通道值除以255。
ready = T.transpose(0, 3, 1, 2) / np.float32(255)
print(ready.shape)   # (2, 3, 2, 3)
print(ready.dtype)   # float32
print(ready[0, 1, 1, 2])  # 约0.627451,即160/255
这里没有使用第七节的通道偏移,因为那是为了说明广播另设的操作,并不是本接口的输入要求。每个环节都应只执行当前任务需要的处理,不能把前面所有展示过的操作依次叠上去。
小叶拿第一张图第二行第三列的绿色作核对:原值160,换轴后应仍属于同一张图、同一空间位置和绿色通道,缩放后应为160/255。检查这个具体位置,比只查看括号是否变成(2,3,2,3)更能发现错把reshape当换轴的问题。
同时,第一张图和第二张图的文件编号按批次顺序保留。如果只单独提交第一张图,使用ready[0:1]保留批次轴;后续合并结果时,再依据编号接回对应文件。若换成变长文本,除了数值批次,还要一起保留长度或有效位置掩码。
这样,小叶解决的就不只是一个输入报错。他能够说明每条轴在区分什么,怎样调整排列而保留对象身份,哪些运算汇总了位置,哪些规则沿哪个轴重复使用,以及补齐以后哪些位置仍不是真实内容。AI可以协助写代码、查接口和定位异常,小叶则有办法检查这些建议是否维护了他真正想处理的那批数据。
十、练习与参考分析
练习一:形状中的数字分别在说什么
另有一批BHWC图像,形状为(5,4,6,3),使用32位浮点存储。它有几个轴、几张图、多少个数?仅数值部分占多少字节?第四张图第三行第五列的绿色如何索引?换成BCHW以后,如何寻找同一个值?
**参考分析:**这批数据有四个轴,包含五张高4、宽6、每像素三个通道的图。每张图72个数,整批360个数;每个32位浮点数占4字节,所以数值数据占1440字节。不能把第一个5称作“张量有五维”,这里的5只是图片轴长度。
按程序从0开始的索引,原值在T[3,2,4,1]。正确换轴后的形状为(5,3,4,6),同一个值在Y[3,1,2,4]。这种核对同时保留了图片、空间位置和颜色身份,比只把四个形状数字换一下更具体。数据类型不改变索引位置;若之后改变数值范围,还需另行说明换算规则。
练习二:相同的目标形状,为什么有两种结果
小叶有一张灰度图,第一行是1、2、3,第二行是4、5、6。他想交换行列含义。请分别写出默认C顺序重塑为(3,2)的结果,以及转置的结果。哪个完成了他的目标?另一个是否把数值删除了?
**参考分析:**默认重塑按原行序读出1到6,再每行放两个数,得到三行分别为(1,2)、(3,4)、(5,6)。转置则把原来的三列各变为一行,得到(1,4)、(2,5)、(3,6)。两者形状相同,含义不同。
目标是交换原行列的角色,因此应采用转置。原第一行第二列的2,转置以后应在第二行第一列;直接重塑后它却在第一行第二列,可以据此检查对应关系。
重塑没有删除这六个数。如果知道原形状和读取顺序,还可以逆向重塑回去。但“仍能恢复原数据”不等于“已经完成当前要求的换轴”。前者判断记录是否可逆,后者判断这次输出是否满足指定的对象对应。
练习三:四张图为什么变成了一张长图
四张图片各自形状为(10,12,3)。小叶希望批量逐张处理,AI却沿它们已有的第0轴直接拼接。结果形状是什么?应该采用怎样的组织?如果原先收到的已经是两批图片,合批时又为什么可以沿第0轴拼接?
**参考分析:**单张图的第0轴表示行,四张沿它拼接,得到(40,12,3)。原来的四块图像还可以占据不同的行区间,但数组没有保存一个用于逐张选择的批次轴。这是把高度加长,不能直接作为要求四张独立图片的输入。
可以沿新的第0轴堆叠,得到(4,10,12,3)。此时每张图仍有自己的十行,第0轴才是图片编号。如果输入本来就是两批BHWC数据,沿第0轴拼接会增加图片数,正好符合合批目的;其余高度、宽度和通道约定需要一致。
应同时保存文件编号的合并顺序。即使形状和像素正确,若输出按另一份编号列表回写,也会把结果配到错误的资料上。
练习四:本来每张图一个结果,为什么得到一张四乘四的表
小叶有四个待修正的结果,列向量形状为(4,1),值依次为10、20、30、40。每条结果要分别减去1、2、3、4,偏移保存为形状(4,)的向量。直接相减为什么得到(4,4)?怎样得到原先想要的四个结果?
**参考分析:**按从右往左的广播规则,(4,)相当于(1,4)。它与(4,1)配合时,一边在行方向复用,另一边在列方向复用,结果为(4,4)。输出中的第i行第j列,是第i条结果减去第j个偏移,因此生成了所有配对,而不是四组逐一对应。
例如第一行会是9、8、7、6,表示10分别减去四个偏移。若目标是各条结果使用自己的偏移,应将偏移明确整理为(4,1),再对应相减,得到列向量9、18、27、36。
也可以让两边都采用形状(4,)的一维表示,再逐项相减;选择哪一种取决于后续接口是否需要保留列轴。修复重点是让两边的“哪条结果”处于同一条轴,而不是从错误大表中碰巧取出几个满意的数字。
练习五:真实的零应该参与平均吗
一份资料有三个真实片段,待核验分钟数为0、3、6。为匹配本批长度5,后面再补两个0。AI用“数值不为0”作为有效位置掩码,算得平均4.5分钟。请判断问题,写出正确掩码和平均值。若这份资料没有任何有效片段,又应怎样处理?
**参考分析:**真实的第一个片段虽然目前不需要额外核验,仍然是一个真实片段。有效掩码应为(1,1,1,0,0),平均为9分钟除以三个片段,得到3分钟。
若按非零值判断有效,就会把真实的0排除,分母错误地变成2,得到4.5。填充值与真实值可以相同,所以应根据原长度或其他明确记录建立掩码。掩码标记的是位置的身份,并不是对数值大小作评价。
若有效位置数为0,就没有可按普通方式计算的片段平均值。应根据任务把它标为缺少有效结果、跳过该项或采用另行规定的处理,不能在未说明规则时自动宣称平均为0。这里缺的是可平均的对象,不是少写了一条除法语句。
练习六:接口检查不能只看形状
两份数组的形状、dtype和数值范围都满足本章假定的下游接口。一份是真正把BHWC换成BCHW后除以255,另一份把原批次直接重塑成BCHW目标形状后除以255。AI说两者输入检查都通过,可以任选。小叶还应怎样检查?检查几个位置是否足以保证整个大型数据系统没有问题?
**参考分析:**形状、类型和范围属于必要的交接信息,却不能证明轴的含义与数值位置正确。可以选取已知图片、行列和通道,检查转换前后是否遵守同一像素的对应关系。本章第一图的绿色160,应到Y[0,1,1,2],缩放后约0.627451;也可以直接核对整个原红色通道是否仍被下游当成红色。
正确的换轴维护这种对应,直接重塑通常只维护读取序列和元素总量。因此,不能仅凭表面检查都通过就任选一种。
几个精心选择的位置能够揭示这类错误,但不能保证所有文件读取、编号、通道顺序、尺寸处理和异常输入都正确。实际系统还应依据任务检查这些环节,并核对完整的小样例,再扩大到批次。这里的目的不是要求无限增加检查,而是让检查对应真实可能错位的关系:输入中的哪个数,在输出中应当属于哪个对象。